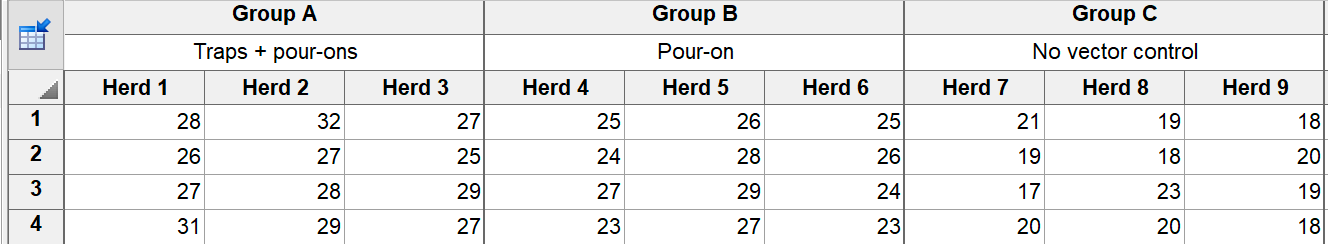
本示例摘自一部优秀的在线统计学教材《如何避免和发现统计学不端行为》。该研究评估了两种病媒控制方法与不采取控制措施相比,对牛的红细胞压积(PCV)的影响。 将三群奶牛随机分配到三种处理组中。从每群奶牛中抽取四头牛的血液样本,并统计其红细胞压积值。
我们关注的因素是处理组。嵌套因素是牛群。由于每个牛群仅接受一种处理,因此牛群因素嵌套在处理组因素之中。
1. 数据录入
创建一个嵌套表,并将其子列数量设置为实际重复次数。在本示例中,每个处理组有三个牛群,因此创建的表应包含三个子列。
将重复牛的数据堆叠后输入。
要为子列添加适当的标签(如下文中的“Herd1”...),请双击子列标题以调出对话框,并在其中输入子列标题。
注意事项:
•请注意,重复数据是堆叠的。这与 Prism 的常规操作方式不同。我们这样设置有两个原因。首先,这允许您为子列标注名称(如上文的“牛群 1”、“牛群 2”……)。其次,这符合大多数文献中进行此类分析的方式。 如果技术重复以并列方式呈现,且不同行对应不同的大鼠,Prism 的嵌套 t 检验分析将产生无意义的结果。
•每个子列中值的顺序是任意的。您可以随机打乱每个子列中的数据,结果也不会改变。第 2 行中的值之间完全没有对应关系。
•子列的顺序无关紧要。即使将“群组 2”和“群组 3”的数据对调,结果也完全相同。例如,控制数据的第二个子列与处理组的第二个子列之间没有任何关联。
•在本示例中,每个子列的值个数相同(均为4个)。嵌套单向方差分析并不要求这一点,即使样本量不等也能正常运行。
•我们使用“嵌套单向方差分析”这一名称,因为它最能准确描述该检验的用途。大多数书籍将其称为嵌套双向方差分析,因为其中一个因素(本示例中为“牛群”)嵌套在另一个因素(“处理”)之中。
•Prism 无法对超大数据集运行嵌套方差分析,并会显示一条提示信息告知用户。究竟多大才算“超大”?详情请参见此处
2. 运行分析
单击“分析”(Analyze),然后从“分组分析”(Grouped analyses)列表中选择“嵌套单向方差分析”。
在第一个选项卡中,选择是否为每个数据集生成总体均值和 95% 置信区间的图表,以及是否在表格结果中显示拟合优度。
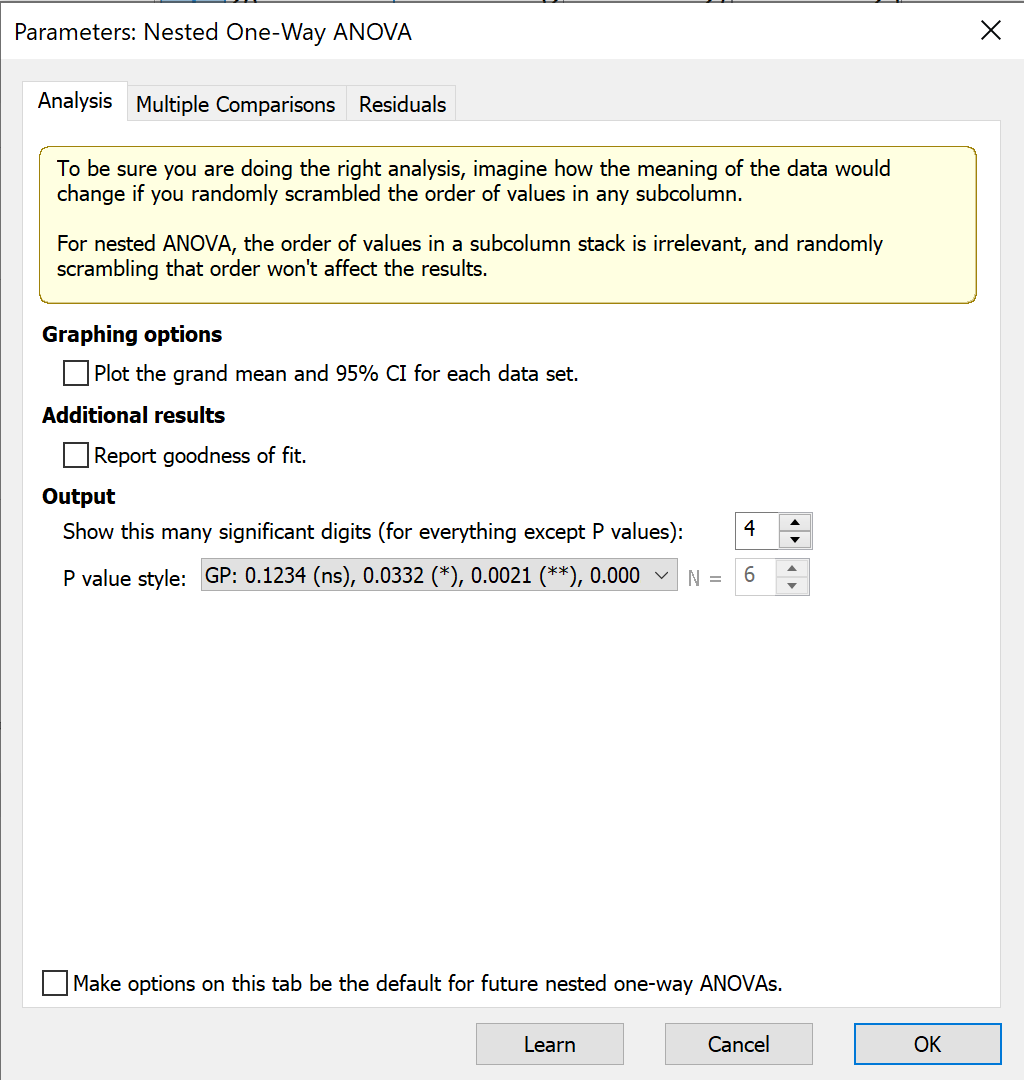
第二个选项卡提供多重比较选项,第三个选项卡则提供多种绘制残差图的选项。
