在数据堆栈中识别异常值非常简单。在“列”数据表中单击“分析”,然后从“列”数据分析列表中选择“识别异常值”。Prism 即使在数据集中只有三个值的情况下,也能执行异常值检验。
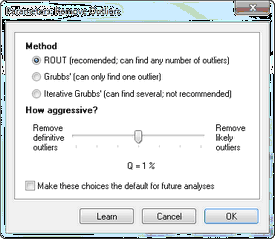
注意:本页介绍如何从设置为“列数据”的数据表中的一组值中识别异常值。Prism 还可以在非线性回归过程中识别异常值。
选择哪种方法?
Prism 提供了三种识别异常值的方法:
ROUT
我们开发了 ROUT 方法,用于在通过非线性回归拟合曲线时检测异常值。Prism 将该方法应用于从列数据表中的数据堆栈中检测异常值。ROUT 方法可识别一个或多个异常值。
Grubbs 法
Grubbs 检验可能是识别异常值最常用的方法。该方法也被称为 ESD 方法(极值斯图登特化偏差)。它只能在每个数据集中识别一个异常值。 Prism采用双侧Grubbs检验,这意味着它将检测出远大于其余值的数值,或远小于其余值的数值。
迭代Grubbs 法
尽管格鲁布斯法最初设计用于检测单个异常值,但通常会被扩展以检测多个异常值。这通过一种简单的方法实现。 如果发现一个异常值,则将其剔除,并对剩余值再次进行格鲁布斯检验。如果第二次检验发现另一个异常值,则剔除该值,并进行第三次检验……
虽然格鲁布斯检验在查找数据集中的单个异常值方面表现良好,但在处理多个异常值时效果并不理想。在小型数据集中,第二个异常值的存在可能会导致第一个异常值无法被检测到。这种现象被称为“掩蔽效应”。 Grubbs 法通过计算某个值与均值的差值,再将该差值除以所有值的标准偏差来识别异常值。当该比值过大时,该值即被定义为异常值。 问题在于,标准偏差是根据所有数值(包括异常值)计算得出的。当存在两个异常值时,标准偏差可能会变得很大,从而导致该比值降至用于定义异常值的临界值以下。请参阅掩蔽现象的示例。
建议
•如果您能确信数据集中要么没有异常值,要么只有一个异常值,则应选择格鲁布斯检验。
•若需考虑存在多个异常值的可能,则应选择 ROUT 法。比较 Grubbs 法与 ROUT 法。
•请避免使用迭代式格鲁布斯法。
•使用 Prism 创建盒须图时,您可以选择显示 Tukey 须线,该功能会在数据点与中位数的距离超过四分位距(第 75 百分位数与第 25 百分位数之差)的 1.5 倍时,单独显示这些数据点。 有些人将这些数据点定义为异常值。我们在 Prism 中未实现这种异常值检测方法(除了绘制盒须图之外),因为它似乎并未被广泛使用,且缺乏真正的理论依据。如果您希望我们加入这种异常值检测方法,请告知我们。
检测阈值应设多严格?
无法将异常值与来自高斯分布的采样值完全区分开来。总会有一些真正的异常值被遗漏,同时也可能将一些“正常数据点”错误地识别为异常值。 您需要决定以多严格的标准来定义异常值。具体选择会因所选的异常值检测方法而略有不同。
格鲁布斯检验。选择 α 值
在格鲁布斯检验中,您需要指定α值。其含义与任何统计显著性检验中的解释一致:若数据中不存在异常值,α即为误将数据点判定为异常值的概率。
请注意,α适用于整个实验,而非每个单独的值。假设您将α设为5%,并对一个包含1000个值的数据集进行检验,这些值均来自高斯分布。此时,最极端的值被识别为异常值的概率为5%。 这5%适用于整个数据集,无论其中包含多少个值。如果将5%乘以样本量1000,并据此推断预计会识别出50个异常值,那便是错误的。
Alpha为双侧,因为Prism中的Grubbs检验会识别出“过大”或“过小”的异常值。
ROUT 方法。选择 Q
ROUT 方法基于错误发现率(FDR),因此您需要指定 Q,即期望的最大 FDR 值。
当不存在异常值(且数据服从高斯分布)时,Q 的解读与 α 相同。当所有数据均来自高斯分布(即不存在异常值)时,Q 即为识别出一个或多个异常值的概率。
当数据中存在异常值时,Q 即为期望的最大错误发现率。 若将 Q 设为 1%,则目标是确保被识别出的异常值中,虚假比例不超过 1%(实际上只是高斯分布的尾部),从而确保至少 99% 的被识别异常值确实是异常值(来自不同的分布)。 若将 Q 设为 5%,则预期被识别出的异常值中,虚假比例不超过 5%,且至少 95% 的被识别异常值是真实的。
建议
其中的权衡关系很明确。如果将 alpha 或 Q 设得过高,那么许多被识别出的“异常值”实际上只是与其他数据点来自同一高斯分布的样本。如果将 alpha 或 Q 设得过低,则无法识别出所有异常值。
目前尚无关于异常值识别的标准。我们建议您首先将 Q 设为 1% 或将 alpha 设为 0.01。
Prism 如何呈现结果
结果分三页展示:
•已清理的数据(已移除异常值)。您可以将此页面作为其他分析(如 t 检验或单向方差分析)的输入。
•仅异常值。
•仅异常值。摘要。该页面列出了每个数据集中检测到的异常值数量。
