主成分回归(PCR)是主成分分析(PCA)与多元线性回归(MLR)的结合。 通常,通过PCA进行降维的目标正是PCR,而Prism软件允许将PCR作为PCA选项的一部分来执行。当选择将PCR作为PCA的一部分执行时,PCA结果中除原有结果外,还将额外包含一个“回归结果”选项卡。
简而言之,先运行PCA,选择若干主成分,然后将所选的主成分得分作为自变量(预测变量)运行MLR。您选择的另一个变量(未包含在PCA中)则作为因变量(结果变量)。
Prism 会在后台执行另一个步骤。它不会以主成分得分的量表报告回归系数,而是将回归系数转换回原始输入变量的量表。
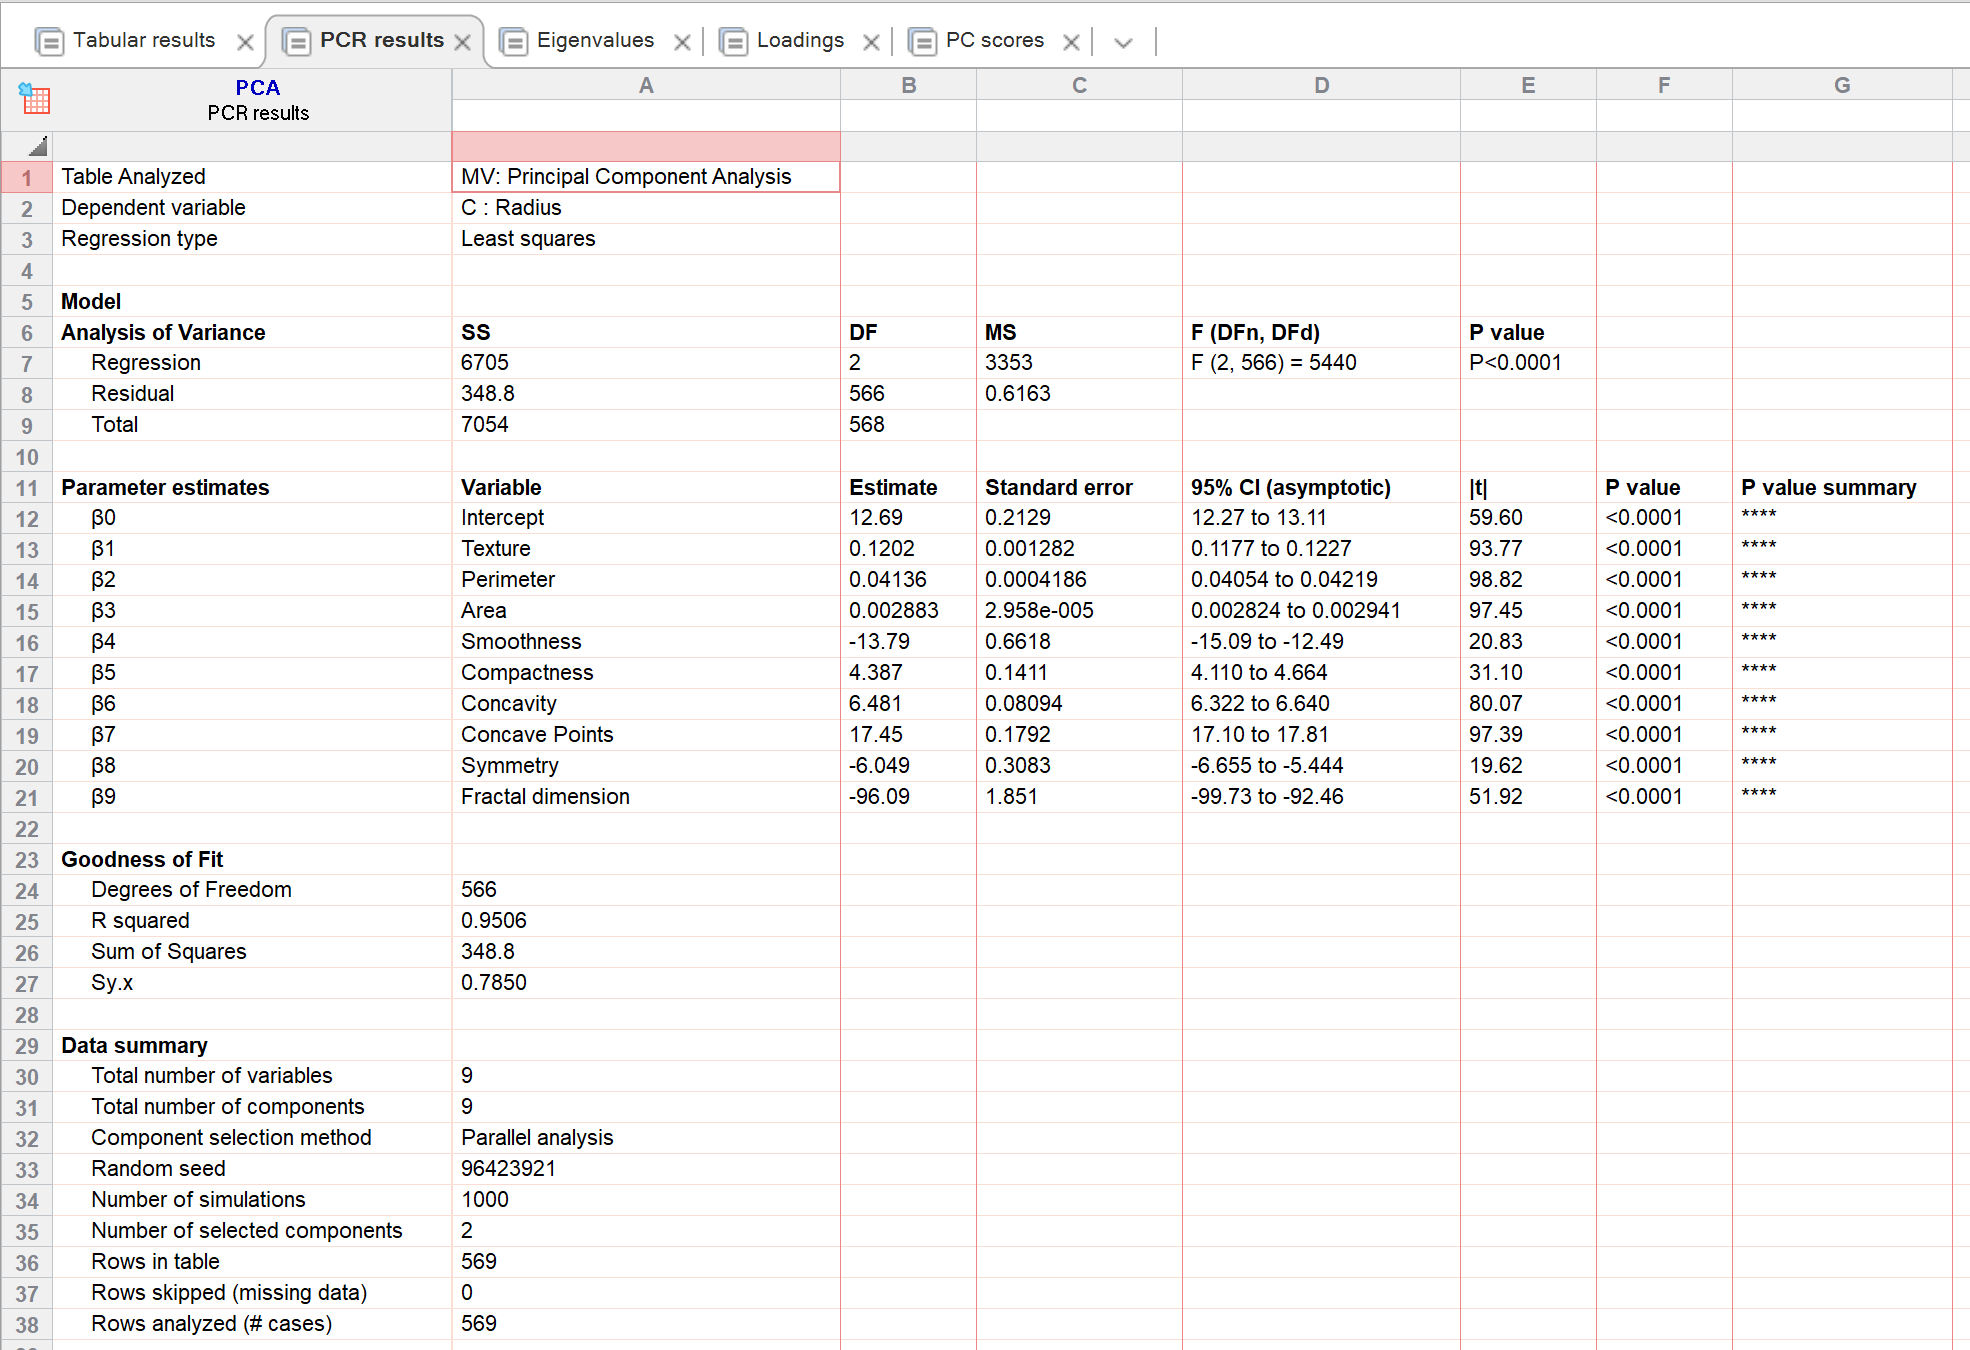
请注意,在下文显示的PCR结果中,回归模型使用了两个自由度,因为仅选取了两个主成分作为独立变量。 但请注意,结果中显示了所有九个独立变量以及截距的系数。这看似令人费解,却正是 PCR 的精髓所在。本质上,多重线性回归(MLR)是基于投影到较少维度的数据进行拟合的(这听起来可能很玄妙,具体解释详见此处)。
除了使用主成分得分拟合MLR外,系数、标准误差和置信区间的解读与MLR完全相同。例如,该模型为
估计的因变量 = β0 + β1*X1 + β2*X2 + β3*X3 + ...
请参阅关于多元线性回归的其他页面,了解如何解读方差分析表、P值和R²。
主成分是PCR的预测变量,而非原始变量
需要注意一个特殊情况。首先,我们将数据点的总数(数据表中的完整行数)称为“N”。此外,我们将选定的主成分(预测变量)的数量称为“k”。
方差分析表中的总自由度定义为 N-1。为什么减去 1?因为截距已被拟合。 回归的自由度定义为 k,残差的自由度定义为 N-k-1。简单验证可知,回归自由度与残差自由度的和等于总自由度:
dfreg + dfres = k + (N-k-1) = N - 1 = dftotal
在“拟合优度”部分,自由度定义为分析的总行数(N)减去参数个数。 参数数与预测因子数不同,因为该模型包含截距项。这意味着参数总数等于预测因子数加 1,即 k+1。因此,要计算“拟合优度”部分中的自由度,最终公式为:
dfgof = N - (k+1) = N - k - 1
本示例包含 569 行数据,结果表显示了 10 个参数(9 个预测因子加上截距)的估计值。然而,回归的自由度仅为 2,残差的自由度为 566。 这是因为回归模型实际上只“识别”了两个主成分作为预测变量(或独立变量)。因此,自由度计算为 569 - 3 = 566(3 是因为它拟合了两个主成分加上截距)。这就是 PCR 的“魔力”。 PCA 过程将独立变量的数量减少到较少的主成分数量(同时不会丢失太多信息),从而为分析“提供了”更多的自由度。
PCR的数据摘要
与PCA表格结果中的数据摘要类似,PCR结果也包含一个“数据摘要”部分。该部分提供了有关原始变量数量、主成分选择方法、所选成分数量(用作PCR的预测因子)以及数据表中行数的信息。 虽然这些数值在PCA和PCR的“数据摘要”中是相同的,但需要注意的是,最后两行关于“跳过行数”(缺失数据)和“分析行数”(案例数)的信息,在PCR中可能与PCA不同。
请注意,要进行PCR,必须从输入数据表中选择一个变量作为回归的因变量(结果变量),且该变量不能作为PCA的自变量。 随后,对所选变量进行PCA分析。如果这些变量中存在缺失值(或被排除),在PCA计算过程中将跳过这些行。 随后,将使用计算出的主成分(PCs)和指定的响应(结果、因变量)变量进行 PCR。对于 PCR,Prism 会检查定义主成分的变量或响应变量中是否存在缺失值(或被排除),并跳过这些变量中任何一个存在缺失值的行。
为确保这一点极其清晰,这里提供另一种思考方式:作为PCA一部分生成的成分,是利用指定输入变量中所有可能的数据(不包括因变量)来定义的。 随后,这些成分将用于与指定因变量的回归分析。如果某行存在缺失值,该行将被排除在回归分析之外,但该行上的其他值仍会参与主成分值的确定。
总结如下:
•在PCA中因缺失值(或被排除)而被跳过的行,在基于同一数据的PCR中也将被排除
•在指定响应变量中存在缺失(或被排除)值的行,仅会在 PCR 中被排除。如果某行仅缺少响应变量的值,但其他所有输入变量均有值,则该行将用于 PCA,但在 PCR 中会被跳过
•因此,对于同一数据集,PCR中“跳过的行(缺失数据)”的数量可能比PCA中更多
