选择输入预先计算的误差值
在创建(或重新格式化)分组表或 XY 表时,您可以选择将表格格式化为可输入预平均数据的样式。
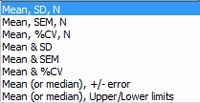
以下是可选项列表:
如果已输入均值和标准差(SD)或标准误(SEM),为何还需要输入样本量(n)?
如果您只想制作一张显示均值和标准差或标准误的图表,只需将这些值输入数据表即可。可以省略“n”值,或者将表格格式设置为输入均值及标准差或标准误,但无需输入n。
在以下情况下必须输入 n:
•您希望能够在绘制标准差、标准误和置信区间误差条之间切换。如果您在输入标准差或标准误时同时输入n,Prism即可根据您的需求在不同形式的误差值绘制之间进行切换。
•您需要进行统计分析。t检验、方差分析(ANOVA)等方法需要知道样本量。
•您希望进行精确的非线性回归。如果您将数据输入为均值和标准差(SD)或标准误(SEM),Prism 将仅拟合均值,并忽略您输入的标准差或标准误值。如果您同时输入 n,Prism 就能考虑数据离散度和样本量,此时的曲线拟合结果将与直接输入原始数据时完全一致。
什么是%CV?
%CV 是变异系数的百分比表示,因此定义为 100 × 标准差 / 均值。由于标准差和均值单位相同,%CV 是一个无量纲的百分比。这仅适用于比率变量,在该类型中,零表示该值不存在。 体重属于比率变量,因为体重为 0.0 意味着没有体重。以摄氏度(C)或华氏度(F)表示的温度不属于比率变量,因为温度为 0.0 并不意味着没有热量。
输入“±误差”与“上下限误差”的区别
在输入预平均数据时,很容易将“+/-”和“上限/下限”这两个选项混淆。但二者是截然不同的。
•当您将子列格式化为输入“+/-”误差值时,您输入的数值将被解读为距离。这些距离将加到(或减去)您输入的均值上,以计算误差条的端点。
•当您将子列格式设置为输入上下限误差值时,您输入的数值将被解读为误差条的端点。误差条将终止于您输入的 Y 值处。
如果我想输入中位数和四分位数,或者其他类型的误差条怎么办?
如果您选择输入均值,并同时输入样本量 (n) 以及标准差 (SD)、标准误 (SEM) 或变异系数 (%CV),则必须精确输入这些数值。否则,分析结果可能会出现错误。
如果您选择设置数据表格式,以便包含“均值”和“标准差”、“标准误”或“变异系数(%CV)”的子列(但未包含样本量),或者设置为“均值”加“±误差值”或“上、下限”,则无法进行任何分析。确切地说,Prism 只会分析/拟合均值,而忽略误差值。 如果您选择将数据表格式化为包含“均值”、“上限”和“下限”这三个子列,您可以随意在这些子列中输入中位数加上第25和第75百分位数,或者您想要的任何其他值。 Prism 会绘制您输入的误差值,但您需要自行记录这些值的实际计算方法,并据此为图表添加相应标签。