当您最关注的参数并非由任何单一数据集决定,而是由两个数据集之间的关系决定时,全局拟合最为有用。
示例数据
选择 XY 数据集:结合——总结合与非特异性结合的饱和结合
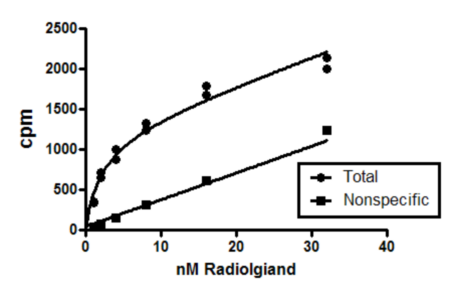
使用非线性回归拟合数据,打开“结合——饱和”方程列表,并选择“单结合位点——总结合与非特异性结合”。您将看到如下所示的拟合结果。
方程说明与全局拟合
本实验通过测量不同浓度放射性配体在受体上的平衡结合情况,以确定该放射性配体的Bmax和Kd值。 由于配体既会结合到目标受体上,也会结合到非特异性位点上,因此该实验同时测定了总结合量和非特异性结合量(即在过量未标记受体拮抗剂存在条件下放射性配体的结合量)。
此类数据的分析通常首先从总结合量中减去非特异性结合量。随后,将所得的特异性结合量拟合到描述单个受体位点平衡结合的模型中。
全局拟合可同时对总结合和非特异性结合量进行拟合。无需先从总结合量中减去非特异性结合量。唯一的诀窍在于编写一个模型,使每个数据集分别拟合不同的方程。Prism 内置方程的设置如下:
特异性=Bmax*X/(X+Kd)
非特异性=NS*X + 背景
<A>Y=特异性+非特异性
<B>Y=非特异性
第一行定义了特异性可饱和结合。
第二行将非特异性结合定义为所加放射性配体(X)的恒定比例加上背景(通常为零)。
第三行前带有 <A>,因此仅适用于第一组数据集(A列,总结合)。它将该数据集中的Y值定义为总结合与非特异性结合之和。
第四行前带有 <B>,因此仅适用于第二个数据集,并定义该数据集中的 Y 值等于非特异性结合。
该方程的定义包含一项约束条件:参数 NS 和 background 在两个数据集之间共享。这样,Prism 便能基于对两个数据集的拟合,为 NS 和 background 找到一个控制数据。由于 Bmax 和 Kd 仅用于拟合第一个数据集,因此共享这些参数没有意义。
您关注的参数(Bmax 和 Kd)无法仅通过拟合单个数据集来精确确定。但通过拟合一个同时定义两个数据集(及其关系)且在数据集间共享参数 NS 的模型,Prism 能够从数据中获取尽可能多的信息。
