逻辑回归模型拟合的回顾
将逻辑回归模型拟合到一组数据的过程,涉及确定该模型参数的一组“控制数据”。 其工作原理是利用迭代算法来最大化逻辑回归模型的似然函数。可以这样理解这个过程:它试图找出“最有可能”产生观测数据的模型参数值。由此衍生出几个重要概念。 首先,这意味着——一般而言——逻辑回归模型在拟合(或分类)输入数据方面的表现,通常会优于其对新数据结果的准确预测能力。
使用该方法的另一个含义是,在某些情况下,算法无法确定参数值,因此无法在此类情况下定义逻辑回归模型。逻辑回归中出现这种情况的三个常见情形包括:完美分离、准完美分离以及X变量的线性依赖度。
完美分离
完美分离(有时也称为完全分离)是指模型能够完美预测数据的情况。换言之,对于给定的预测因子(或若干预测因子的线性组合),当该预测因子值高于某个阈值时,总会出现一种结果;而当该预测因子值低于该阈值时,则总会出现另一种结果。 这听起来可能有些令人困惑,但在实践中,其含义是模型会将每个输入值为 0 的数据点正确分类为负结果,将每个输入值为 1 的数据点正确分类为正结果。从表面上看,这似乎不是什么大问题,因为逻辑回归的目标之一就是对观测结果进行分类。 然而,逻辑回归的另一个目标是找到模型参数的最佳拟合估计值。完美分离的问题在于,在这种情况下,不存在能使似然函数最大化的唯一一组最佳拟合值。让我们看一个简单的示例:
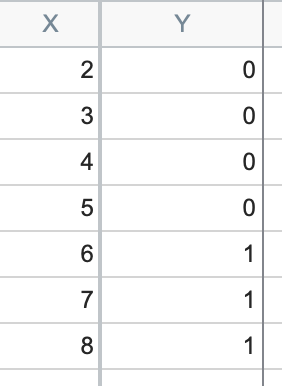
可以看出,对于所有小于或等于 5 的 X 值,Y 值均为 0;而对于所有大于 5 的 X 值,Y 值均为 1。当仅有一个预测因子(如简单逻辑回归)时,我们可以直观地理解“完美分离”的含义:
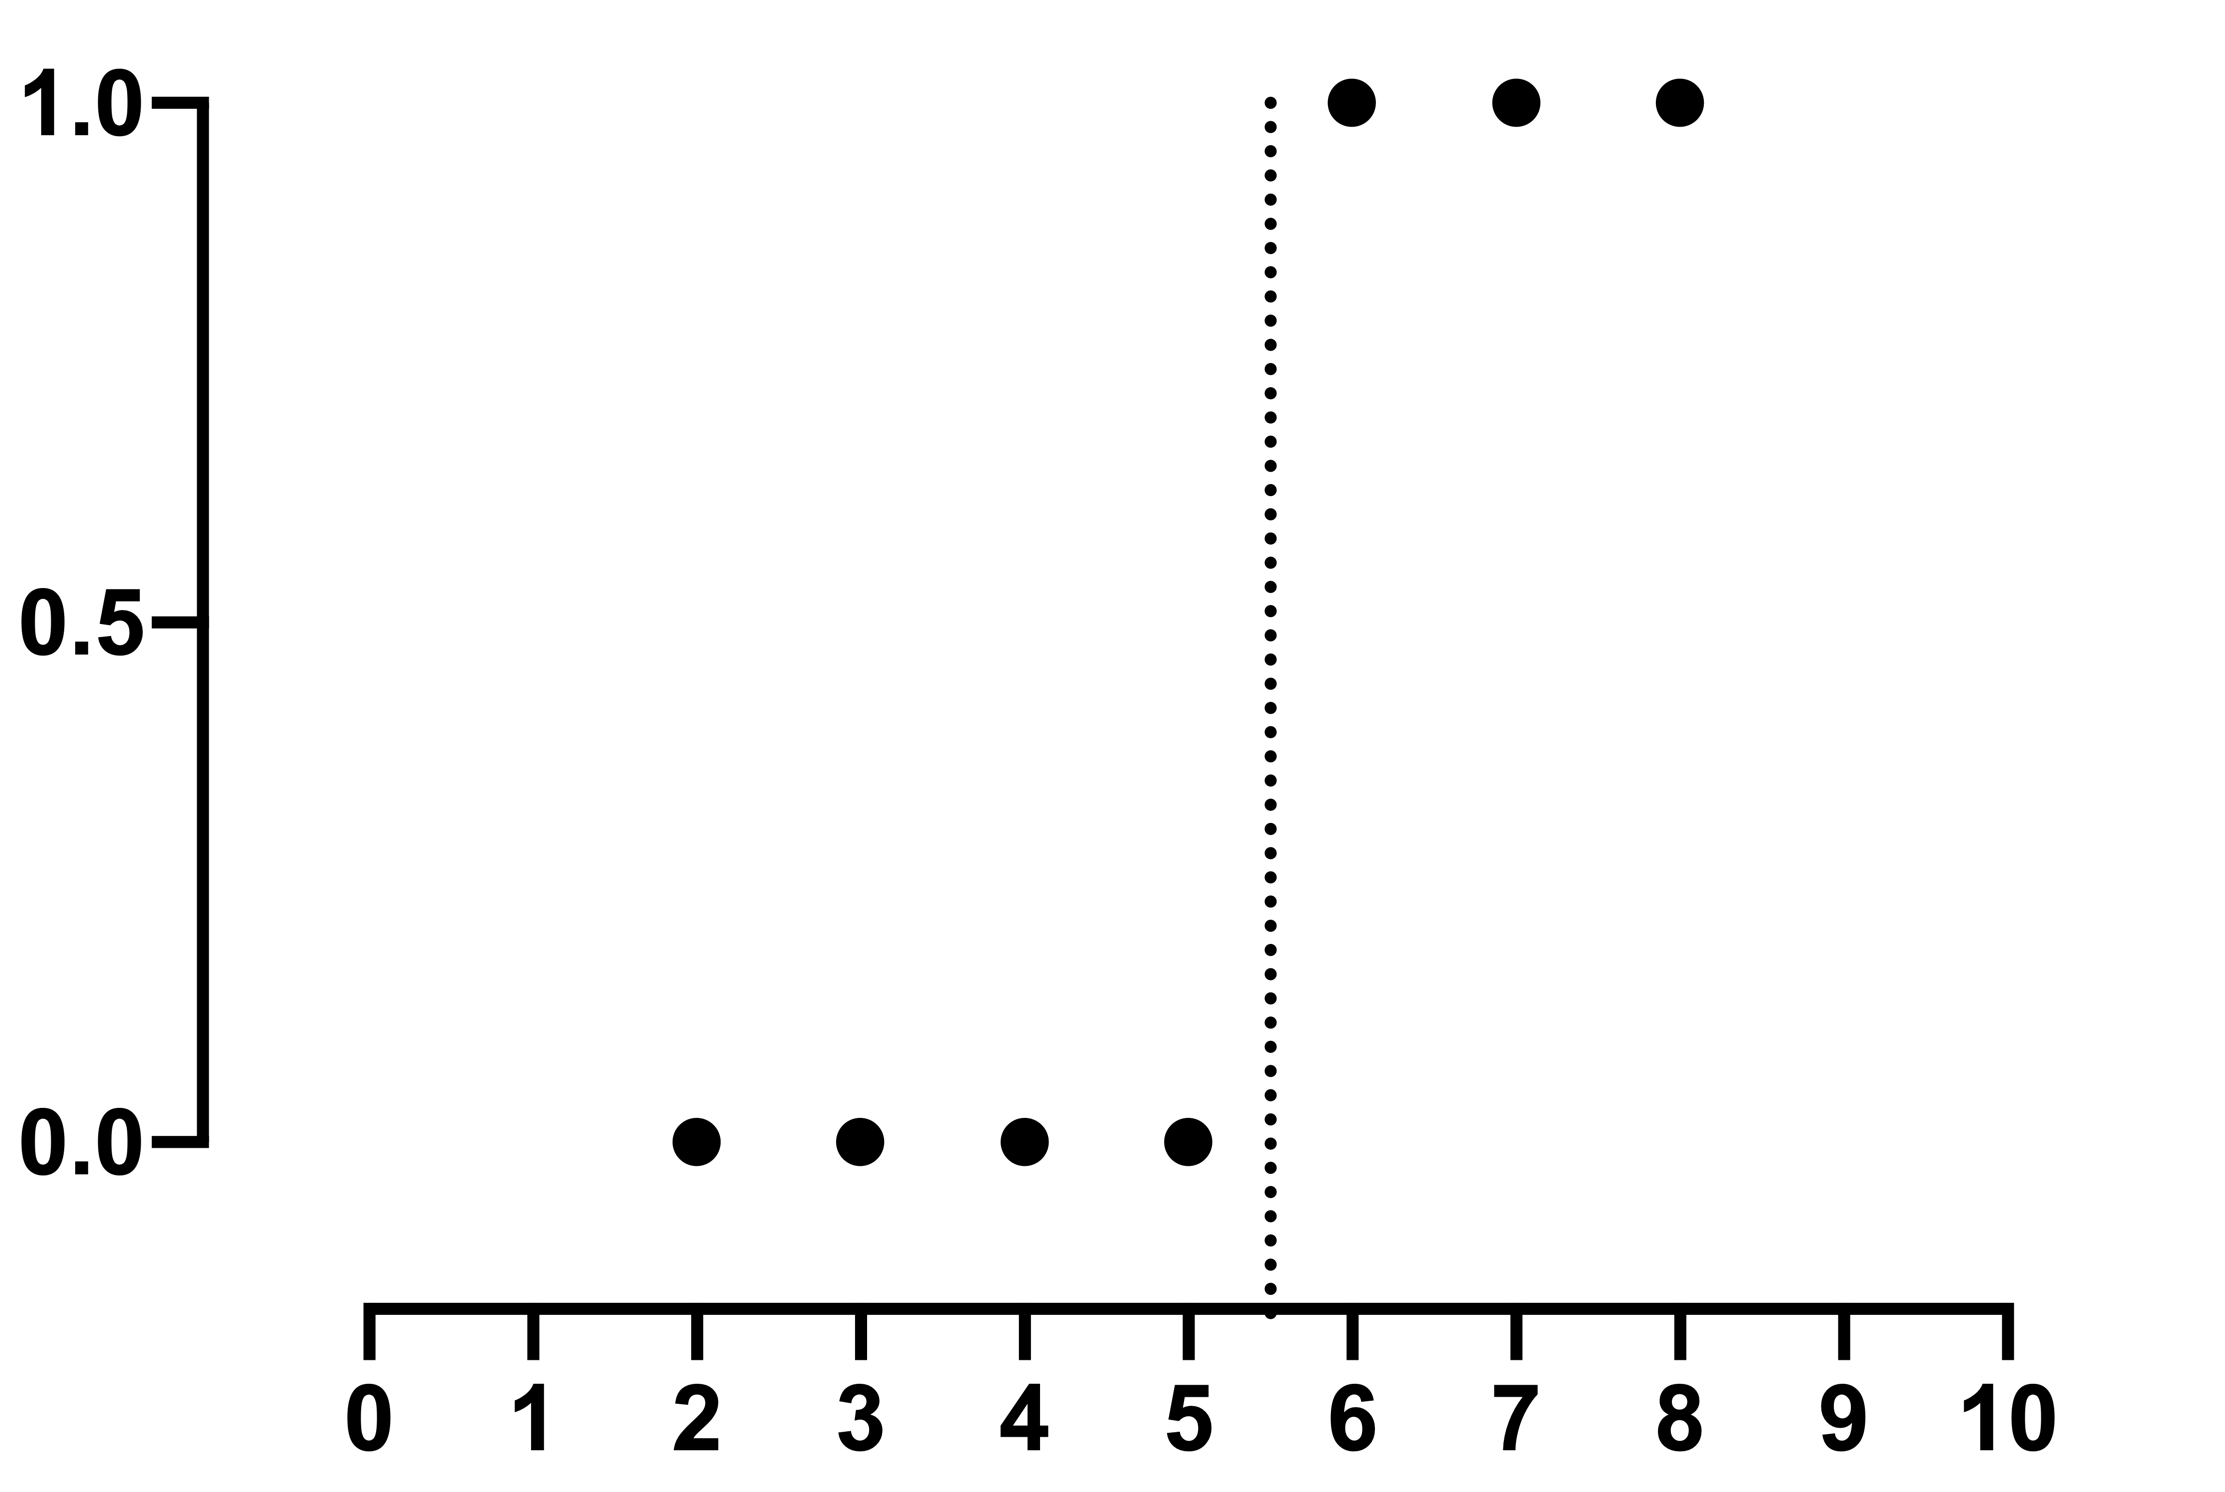
显然,可以在 X=5 和 X=6 之间画一条垂直线,该线左侧的所有点 Y 值均为 0,右侧的所有点 Y 值均为 1。因此,根据 X 值很容易预测结果。 但S形的逻辑斯蒂曲线无法完成这项任务,因为数据无法提供任何线索,表明该曲线在5和6之间应位于何处。如果X=5.5,预测概率是多少?
准完美分离
准完美分离是与完美分离密切相关的一个问题。当一个预测因子(或预测因子的线性组合)能够正确分类结果,仅在单一值或点上出现错误时,就会发生准完美分离。让我们再次通过一些数据来更好地理解这个问题:
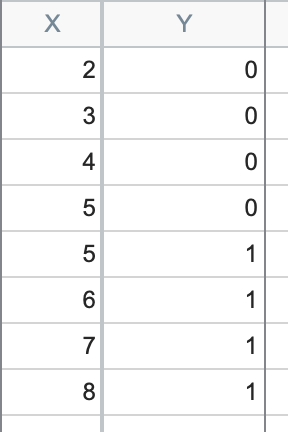
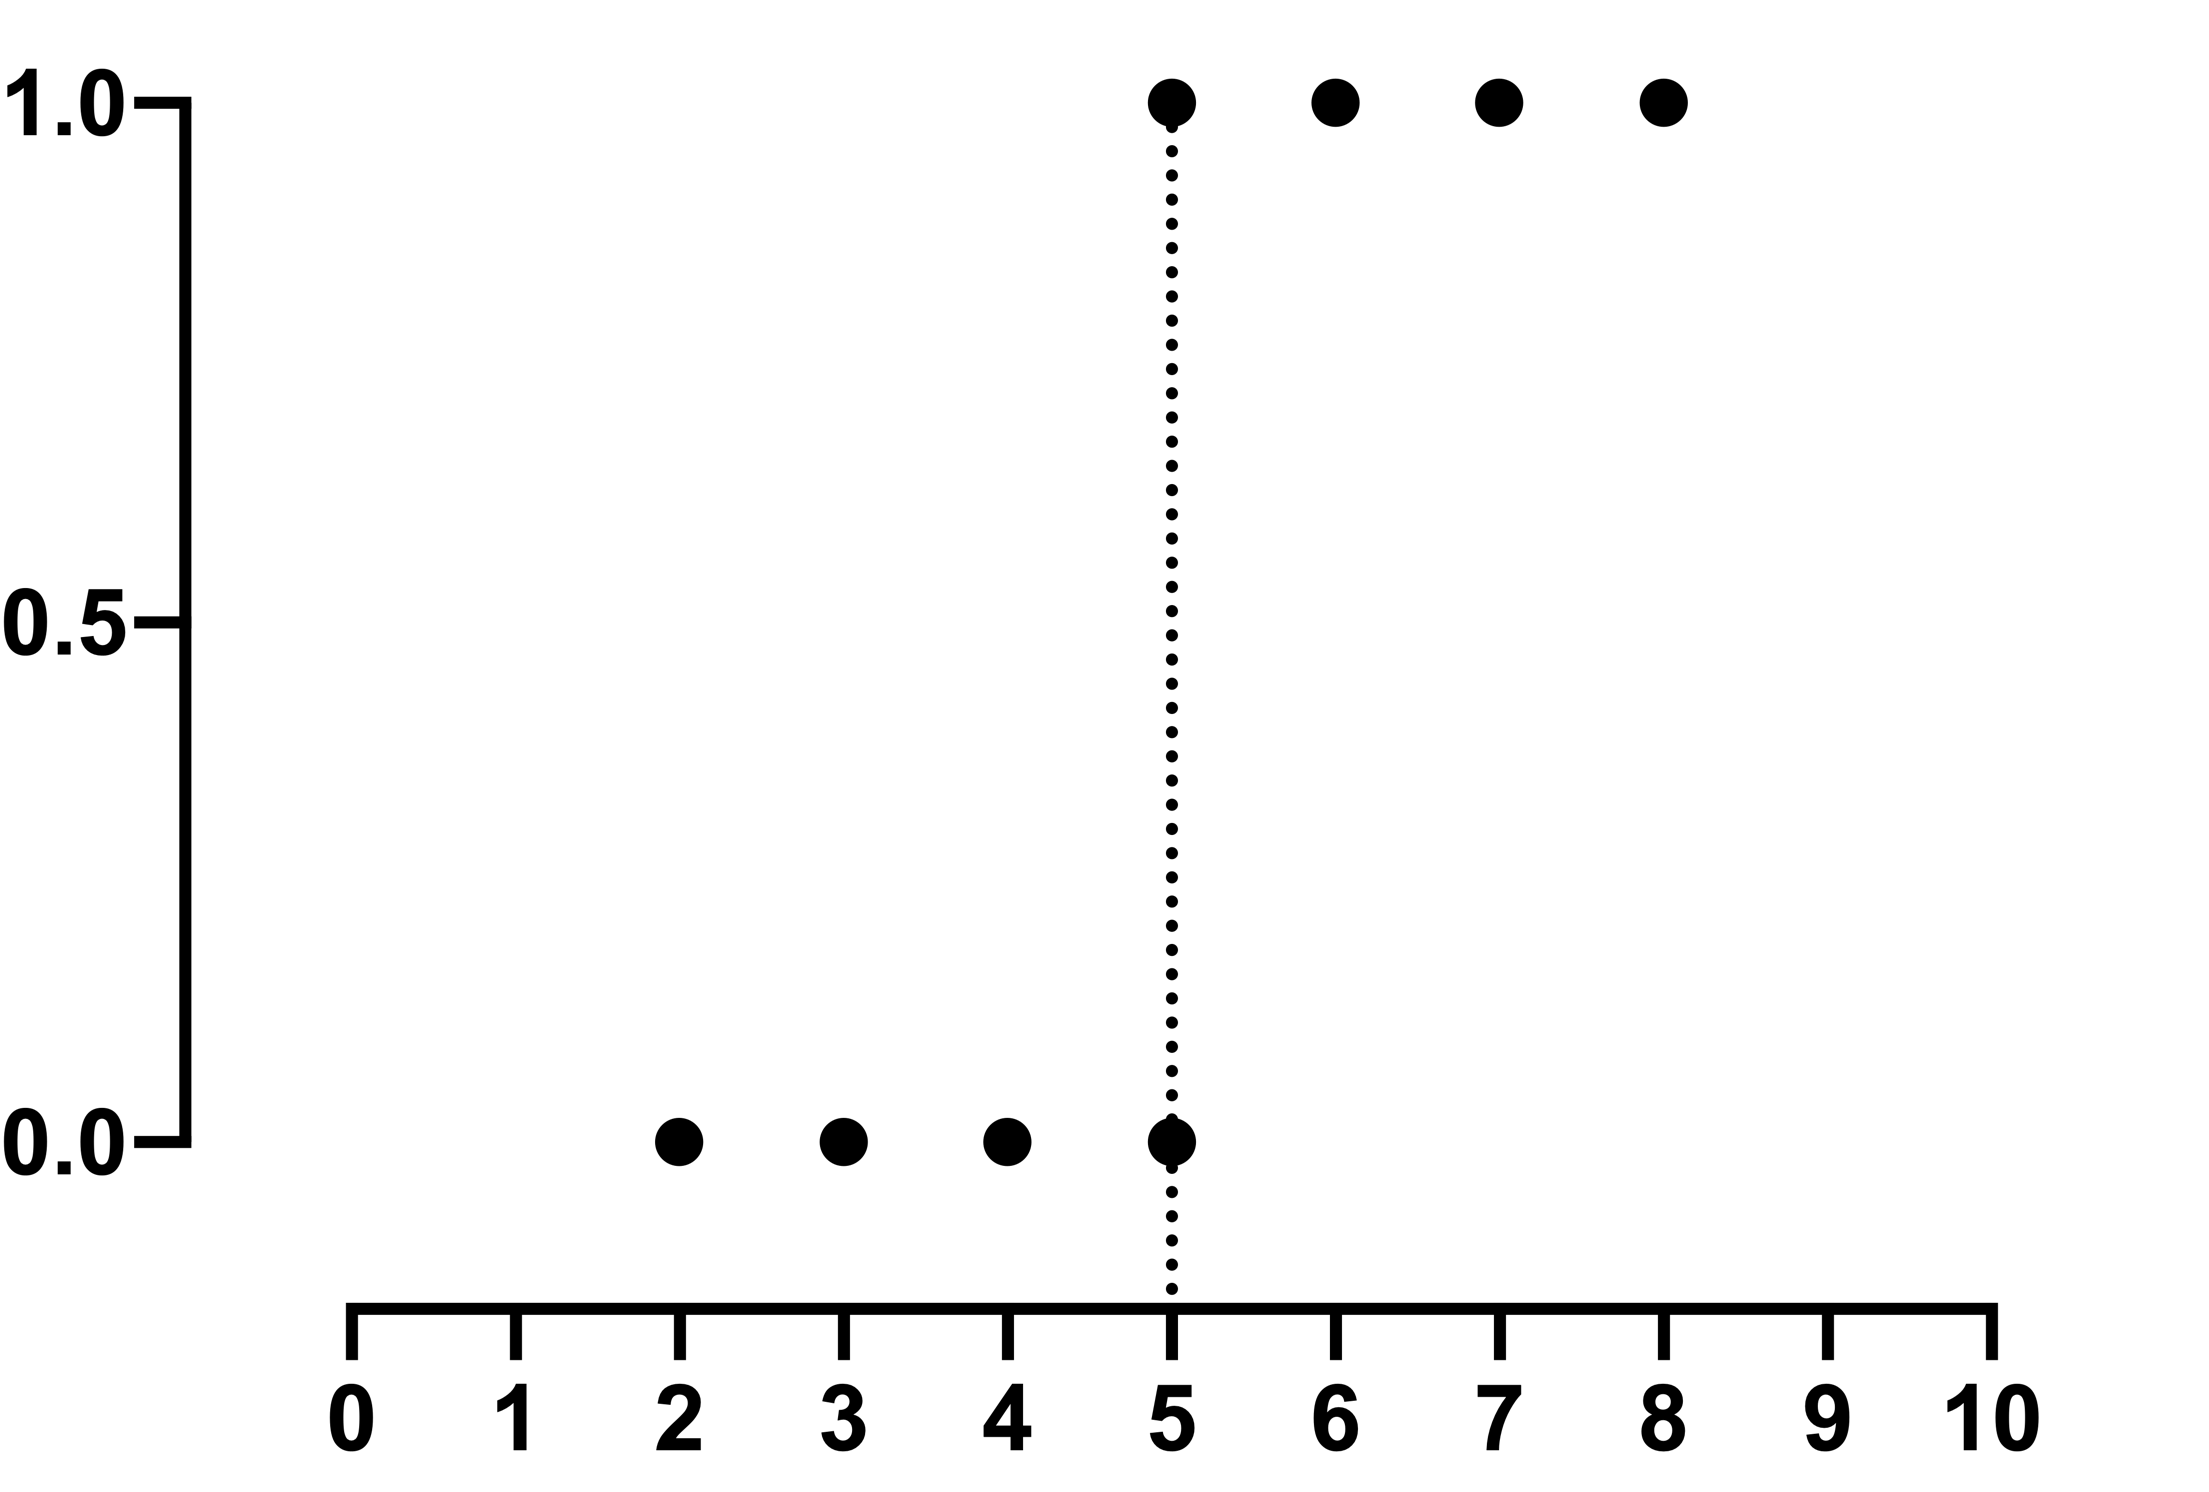
现在您可以看到,对于所有小于5的X值,Y值均为0;而对于所有大于5的X值,Y值均为1。然而,当X=5时,我们既会得到Y=0,也会得到Y=1。 同样地,此时无法最大化似然函数,因此无法确定参数的最佳拟合估计值。
最后,如果所有 X 值都相同,Prism 将无法对数据拟合逻辑回归模型,也无法最大化似然函数(参见下文关于线性相关的 X 变量的说明)。
但请注意,如果出现此错误,并不一定意味着您的实验设计或数据存在问题。这可能仅仅意味着您已经找到了能够完美(或近乎完美)预测结果的X变量(或多个X变量)!
线性依赖的自变量
在尝试对数据拟合逻辑回归模型时,另一个可能的问题是存在线性相关的自变量。当模型包含线性相关的预测变量时,拟合模型的算法将失败,因为似然函数的最大值不存在。为了理解这一点,让我们先定义什么是线性相关。 如果任何一个自变量可以表示为其他变量的线性组合,则称这些变量之间存在线性依赖关系。但除非我们进一步定义“变量的线性组合”的含义,否则这一解释并无太大帮助。 变量的线性组合是指给定变量集的和,其中每个变量都乘以一个常数。这可能通过一个例子来解释最简单。假设您有三个变量:X1、X2 和 X3。现在,我们写一个公式:
X3 = A*X1 + B*X2
如果存在任何使该表达式成立的 A 和 B 的值,那么 X3 就是 X1 和 X2 的线性组合。让我们来看一些数据,以便更清楚地理解这个概念:
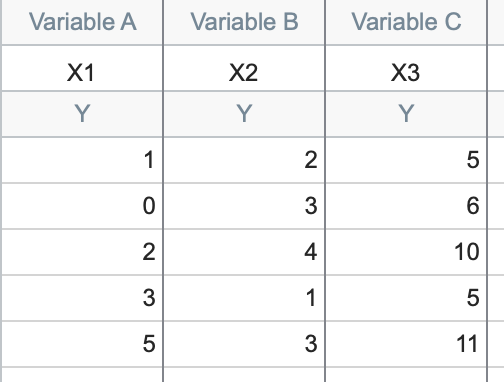
这组数据展示了我们的三个变量(变量可以是任何内容:年龄、身高、走到洗手间的步数……)。对于这组数据,线性关系很容易识别:
X3 = 1*X1 + 2*X2
换句话说,在每一行中,第三个值都是第一个值加上第二个值的两倍。其他线性关系可能并不那么容易发现:
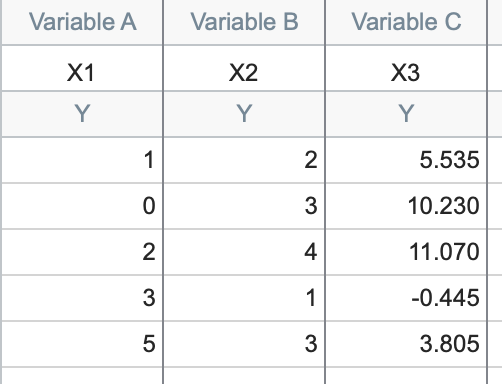
前两列的数值相同,但这里的线性关系可表示为:
X3 = -1.285*X1 + 3.41*X2
线性依赖度问题还可能以另一种形式出现,即当存在重复的 X列时。在使用经过编码的分类预测因子时,这种情况可能会无意中发生。 编码后的分类预测变量只能取有限数量的值,因此不难理解,两个原本互不相关的分类变量为何会在每个观测值上恰好具有相同的值(如果变量之间存在某种关联,这种情况就更可能发生)。 当然,随着观测值数量的增加,这种情况偶然发生的几率会降低。
一个易于理解的变量完全相同的示例可以来自足球比赛的分析。 假设使用了一个变量来表示“进球数”,而第二个变量可能是“最终比分”。虽然在此情况下情况显而易见,但您应始终警惕模型中伪装成自变量的重复(或线性相关)变量。
如果存在重复的X列、完全相关(完美相关)的X列,或者具有更复杂线性关系的X列,那么优化算法将无法运行。要评估此问题,请使用多元逻辑回归对话框中的“多重共线性”选项。更多详细信息请参阅多重共线性页面。
逻辑回归模型收敛性方面(部分)潜在问题的总结
1.0 或 1 的数量过少(我们建议,如果可能的话,每个自变量(X)至少有 10 行)
a.在极端情况下,如果所有数据均为 0(或均为 1),则必然会发生完美分离,因为算法无法区分这两种结果。
b.另一种极端情况是,X 变量的数量与数据行数相等或更多。在此情况下,无法估计模型误差。
2.您的某个 X 变量(或 X 变量的线性组合)会导致 Y 变量呈现完美分离或准完美分离。
3.您的X变量之间存在线性依赖度。
