为什么需要初始值?
在执行非线性回归之前,Prism 必须为方程中的每个参数设定初始值。随后,它会通过迭代调整这些值,以改善模型对数据的拟合效果。 初始值必须合理,这样由这些初始值定义的曲线才能大致符合数据的形状,且不会与数据点产生过大的偏差。如果初始值非常不合理,Prism 可能无法拟合模型。
对初始值的需求并非 Prism 独有,而是非线性回归固有的特性。
为何需要初始值规则?
Prism 可以存储规则(算法),用于根据您的数据范围计算初始值。如果您选择内置方程,则规则已自动处理。 如果您输入自定义方程,也可以输入规则来定义每个参数的初始值。如果您输入了一套合理的规则,那么您的方程今后就能正常运行,无需再考虑初始值的问题。
如果您未设置初始值规则,则每次拟合数据时,都需要为每个变量、每个数据集分别输入初始值。
如果输入的规则不合理,则初始值生成的曲线将无法贴近数据点,Prism 很可能无法将模型拟合到数据上。
如何输入规则
在输入或编辑用户自定义方程时,单击标有“初始值规则”的选项卡。对于每个参数,在第一列中输入一个数字,并选择一个乘数或除数。
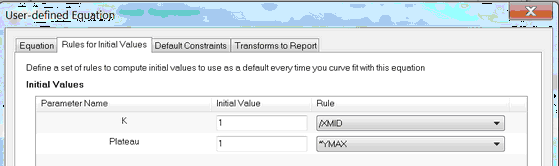
通常情况下,您会使用基于 YMIN、YMID 或 YMAX 的选项,即数据集中的最小、中间(最小值与最大值的平均值)和最大 Y 值,或者相应的 XMIN、XMID 或 XMAX。
您还可以让 Prism 进行插值,例如将初始值基于 X 在最小值与最大值之间中点处的 Y 值(XatYmid)及其相关值的插值结果。
待拟合的初始值
下拉列表中的第一个选项是“(待拟合的初始值)”。这意味着您在左侧框中输入的值将作为所有数据集的初始值。 初始值不依赖于数据的范围(不会进行计算);它就是您实际输入的值。
基于数据范围的初始值
大多数规则都基于 X 和 Y 值的范围。
缩写 YMIN 表示 Y 的最小值;YMAX 表示最大值;YMID 表示 YMIN 和 YMAX 的平均值。 例如,如果您在第一列中输入“0.5”,并在第二列中选择“YMAX”,Prism 会将初始值设置为 YMAX 的一半(该值因数据集而异)。
短语“X at YMID”是指与最高和最低 Y 值平均值相对应的 X 值。计算详情。
SIGN(YatXmax - YatXmin)
如果曲线从左向右总体呈上升趋势,则该值等于 +1:/
若曲线从左向右总体呈下降趋势,则结果为 -1:\
该值用作剂量反应曲线中Hill斜率的初始值。
以下是数学原理的解释。SIGN() 函数在输入正数时返回 +1,输入负数时返回 -1。YatXMax 是最大 X 值处的 Y 值。YatXmin 是最小 X 值处的 Y 值。 当曲线向上时,(YatXmax - YatXmin) 为正值;当曲线向下时,该值则为负值。
列标题值的均值(或该均值的对数)
对于某些类型的数据,对数据集进行数值标注是合理的。每个列标题都有一个数值。
对于此类数据,您可以通过两种方式获取列标题值:
•使用“约束”选项卡并选择“数据集常量(=列标题)”。此时模型中的该参数成为常量,但该常量的值会因每个数据集列而异,其值取自列标题。
•在定义方程的对话框中,于“初始值规则”选项卡上,将参数的初始值设置为这些列标题的均值,或该均值的对数。
通过一个示例来理解这一点最为直观。调出竞争性酶抑制作用的示例 XY 数据,按照说明操作,并检查对话框中的设置。
初始、中间和最终斜率
Prism 7 新增功能:将初始值基于初始、中间或最终斜率(X 值最小、中间或最大时的 dY/dX)或其倒数。
示例
Y = Vmax*X/(Km + X)
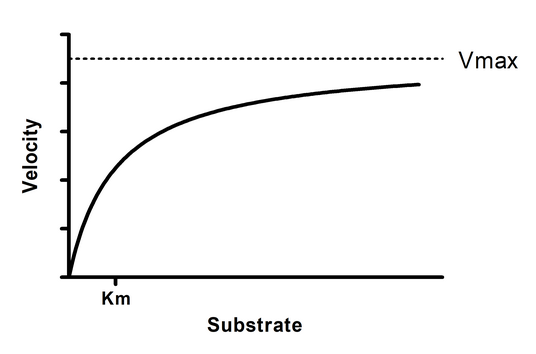
上述方程是 Prism 内置的米氏-门捷列夫酶动力学模型。如果您选择此方程作为内置方程,系统会自动提供初始值的规则。但如果您将其作为新的用户自定义方程输入,则很容易制定相应的规则。
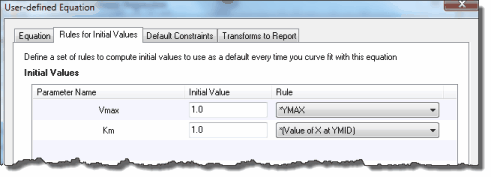
Vmax 是 X(底物)值非常高时对应的 Y 值(酶速率)。 因此,一个合理的初始值是将 Vmax 设为数据集中最大的 Y 值。要实现这一点,请输入数值 1.0 并选择乘数 *Ymax。这意味着 Prism 将通过将最大的 Y 值乘以 1.0 来计算初始值。 您可能会认为 Vmax 通常高于最大的 Y 值,因此应将 1.25 倍的 Ymax 作为初始值。通常存在多种可以论证的规则。这些规则仅用于计算初始值,因此存在很大的调整空间。
Km 是对应于 Y 值(酶速率)为 Vmax 一半时的 X 值(底物浓度)。通过将 1.0 与“Ymid 处的 X 值”相乘来计算其初始值。 随后,Prism 会取最大和最小 Y 值的平均值来计算 Ymid,然后通过直线插值法确定相应的 X 值。
XMIN、XMID 或 XMAX 处的斜率
这些是图表左侧、中间或右侧的斜率(Y值的变化量除以X值的变化量)。如果数据点有30个或更多,Prism将根据前10%、中间10%或后10%的数据点计算斜率。 如果数据点少于 30 个,Prism 将根据前、中或后两个数据点计算斜率。
如果数据点超过 30 个,则通过对前 10%、中间 10% 或后 10% 的数据点进行线性回归来确定斜率,并向下取整。如果数据点少于 30 个,则通过前两个或后两个数据点确定斜率。 对于数据点少于 30 个的 slopeAtYmid,如果数据点数量为偶数,Prism 将使用两个中间点;否则,将使用三个中间点。
如果未输入任何规则会怎样?
如果您未为每个参数输入规则,Prism 将在每次将数据拟合到方程时,要求您输入初始值。
如何覆盖规则定义的初始值
规则与每个方程一同存储,并可在定义和编辑方程的对话框中进行编辑。
规则定义的值显示在非线性回归对话框的“初始值”选项卡中。要覆盖初始值:
1.在对话框顶部选择一个或多个数据集。或者单击“全选”以选择所有数据集。
2.取消勾选“自动选择”选项。
3.输入初始值(以数值形式,而非规则)。
要检查初始值的合理性,请转到“诊断”选项卡并勾选以下选项:
(*) 不要拟合曲线。而是绘制由参数初始值定义的曲线。
如果生成的曲线与数据不接近,请在要求 Prism 将模型拟合到数据之前,修改初始值(或生成这些值的规则)。
