在进行任何类型的回归分析时,人们通常会关注该模型与其他可能拟合的模型相比,对数据的描述效果如何。Prism 提供了一系列方法,可用于评估模型对给定数据的拟合效果。 具体而言,对于Cox比例风险回归,Prism将报告以下指标的数值:赤池信息准则(AIC)、偏对数似然(LL)、偏对数似然的变换值(-2*LL)以及伪R平方。
赤池信息准则(AIC)
该值源自信息论方法,旨在评估数据与模型的拟合程度。报告的数值依赖于偏对数似然(下文将描述),也依赖于模型中的参数数量。 请注意,由于在存在删剪数据的情况下难以指定观测值数量,Prism(与其他应用程序一样)仅报告AIC,而不报告校正后的AIC(AICc)。计算AIC所需的公式如下:
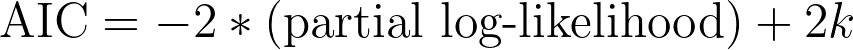
其中 k 为模型中的参数个数(由 Prism 在结果的数据摘要部分报告)。
AIC的解读
AIC的解读在很大程度上依赖于模型拟合的似然(更具体地说,是对数似然,或者在Cox回归的情况下,是偏对数似然)这一概念。 无需深入探讨似然度的数学原理,其基本思想是:模型的似然度反映了数据与该模型的拟合程度(另一种理解方式是:假设所选模型是“真实”模型,则这些数据由该模型生成的“可能性”有多大)。 基于此,可以理解的是,“好的”模型会产生较高的似然值,而“差的”模型则具有较低的似然值。
在上式中,我们可以看到AIC的依赖度取决于两点:
1.模型的偏对数似然
2.模型中的参数个数 (k)
对于Cox回归模型而言,偏对数似然值即为偏似然值的对数。 如上所述,与数据拟合良好的模型其似然值会高于与数据拟合不佳的模型。因此,与数据拟合良好的模型的偏对数似然值也会大于与数据拟合不佳的模型的偏对数似然值。 通过将该值乘以一个负数,我们可以发现,数据拟合效果更好的模型,其“-2*(偏对数似然)”的值会比数据拟合效果较差的模型更小。 因此,我们可以看出,更大的似然值最终会导致更小的AIC值(忽略稍后将讨论的2k项)。所以,AIC值越小代表模型拟合“越好”,这合乎逻辑。
AIC 公式的第二部分是一个“惩罚”项,旨在防止过拟合(即模型中使用过多参数)。对于任何模型,在其他条件不变的情况下,增加参数通常都会提高模型拟合的似然值。 当参数数量足够多时,您将能够完美地预测输入数据集中的数据(但该模型几乎肯定无法准确预测输入数据之外的未来观测值)。这就是过拟合的问题:模型对输入数据的拟合过于紧密。 AIC 公式会增加一个值,该值等于模型中参数数的两倍(2k),因此参数更多的模型,其 AIC 值会被施加更大的“惩罚”。
综合以上信息,我们可以更深入地理解 AIC:
•在同一数据集上,AIC 值较小的模型表明其拟合效果优于 AIC 值较大的模型
•参数更多的模型虽然似然值更大,但其AIC值也会因“惩罚项”而增大
关于 AIC 值需要特别注意的最后一个重要概念是:AIC 值只能在拟合于同一数据集的模型之间进行比较!AIC 值是根据似然函数计算得出的,而似然函数是针对所分析的数据集特异性的。因此,试图比较拟合于不同数据集的模型的 AIC 值是毫无意义的。 另请注意,我们使用AIC的差值来评估一个模型的拟合效果是否“优于”或“劣于”另一个模型,而非AIC值的比值。该比值无法直接解读,因此不予报告。
因此,解读 Prism 中 Cox 回归所报告的 AIC 的最佳方式,是将指定模型的 AIC 值与基于同一数据拟合的零模型或另一个(竞争)指定模型进行比较。 与零模型比较时,指定模型的AIC值越小,表明所选参数改善了模型的拟合效果。在比较两个竞争模型时,在考虑每个模型所包含的参数数量的情况下,AIC值较低的模型被认为总体拟合效果更好。
关于AIC的深入信息
在比较模型时(例如,比较基于同一数据的两个竞争模型,或将指定模型与零模型进行比较),可以利用每个模型的相应AIC值来计算每个模型正确的“概率”(在假设这些是唯一可能的模型,因此其中一个必定正确的条件下)。为此,我们可以利用两个AIC值之间的差值。首先,为每个模型定义一个新值:
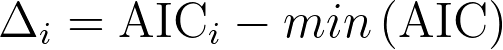
其中 AICi 是该模型的 AIC 值,min(AIC) 是待比较模型中所有可能 AIC 值中的最小值。 请注意,对于 AIC 值最小的模型,AICi 将等于 min(AIC),因此该模型的 Δi 将为零。一旦获得了每个模型的 Δ 值,即可使用以下公式计算每个模型正确的“概率”:
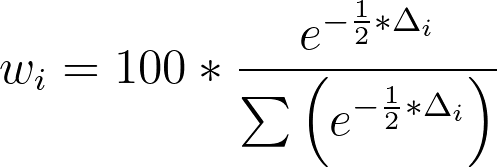
举例来说,考虑比较两个具有以下 AIC 值的模型:
•模型 1 AIC:283
•模型 2 的 AIC:285
因此,这两个模型的Δ值分别为:
•模型 1 Δ:0
•模型 2 Δ:2
各模型正确的概率计算如下:
•模型 1 的 w 值:73.11%
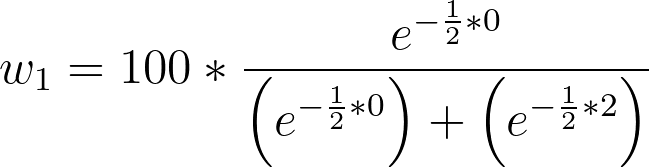
•模型 2 的 w 值:26.89%
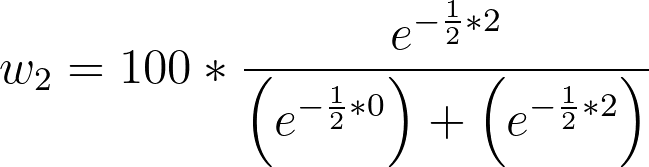
该方法可扩展以处理任意数量模型的比较,但请注意,此方法的假设是:被比较的模型中有一个是“真实”模型(尽管在实际应用中,这一假设可能完全不成立)。
偏对数似然 (LL)
似然度的概念在数学上相当复杂,它被用于Cox比例风险回归分析中估计最佳拟合参数值的过程。然而,利用偏对数似然度来评估模型拟合优度的方法(幸运的是)相当简单。 一般而言,在比较两个拟合于同一数据的模型时,对数似然值较大的模型被认为“拟合”更好。请注意,这些对数似然值通常为负值!在这种情况下,较大的值即为负值较小的值。因此,负值较小的模型被认为“拟合”更好。
选择此选项后,结果中将给出无协变量模型(零模型)和指定模型的偏对数似然值。 如果所选模型的偏对数似然值小于零模型的负对数似然值,则表明输入数据由指定模型生成的可能性大于由零模型生成的可能性。 然而,通常使用各模型的 AIC 值来确定哪个模型“更好”(AIC 值越小,表示模型拟合度“越好”)。
负两倍偏对数似然值 (-2*LL)
与 Prism 在结果部分报告的其他数值一样,该值与偏对数似然相关,可用于评估模型对给定数据的拟合程度。如前所述,在计算 AIC 时会直接使用“-2*(偏对数似然)”这一数值。 幸运的是,一旦获得了(Prism报告的)偏对数似然值,计算该值就只需乘以-2即可!其他程序和书籍有时会以其他等效形式给出该公式:
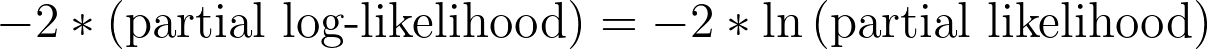
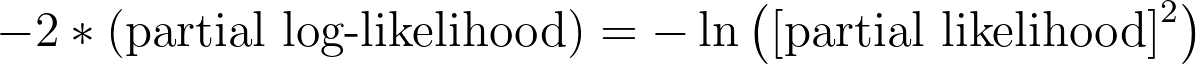
伪R²
在考虑回归分析的“拟合优度”时,通常会涉及R平方的概念。该指标可估算模型解释的方差,在进行多元线性回归时非常有用,但对于Cox比例风险回归,无法计算相同的指标。 因此,人们提出了许多其他“伪R平方”的替代指标。请注意,这些值与R平方在数学解读上并不相同。 伪R平方值并不代表指定模型所解释的方差比例。相反,这些伪R平方值通常用于比较同一数据集上多个模型的拟合优度。
如果在Cox比例风险回归的参数对话框中选中该选项,Prism将报告Cox-Snell R平方(有时也称为“广义”R平方)。该值是根据以下公式,利用指定模型和原模型(不含协变量的模型)的似然值计算得出的:
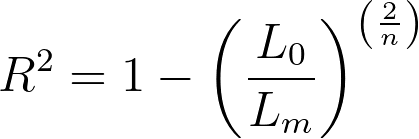
其中 Lm 是指定模型的部分似然值(注意,不是对数似然值),L0 是无协变量模型(原模型)的部分似然值,n 是模型中使用的观测值数量(包括删剪观测值)。
从该伪R²的计算公式可以看出,当模型对数据的拟合效果更好(即Lm的偏似然值更高)时,该分数会变小,而R²值则会变大。 当给定模型的偏似然值较小时,该分数会变大,相应的 R² 值也会变小。与普通(最小二乘回归)回归中的 R² 值类似,该公式的最小值为 0(如果指定模型的偏似然值与零模型相同,则 R² 将等于零)。 然而,与标准R²不同,该伪R²的上限并非1!相反,如果模型与数据完美吻合且模型似然值为1,则所得方程为:
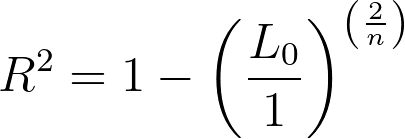
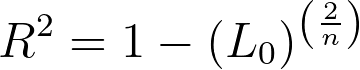
原模型的偏似然值通常极小,但并非零。因此,Cox-Snell R² 的最大值依赖于原模型的似然值,可能非常接近 1(有时甚至接近到计算机无法计算出差异),但未必等于 1。
总结如下:
•该伪R²的最小值为0.0
•该伪R²的最大值小于1.0,但在许多情况下非常非常接近1.0
