首先,我们将“危险率”定义为:在假设截至某一时刻目标事件尚未发生的情况下,该事件在单位时间内的发生频率。危险率越高,意味着在给定时间内发生的事件越多;反之,危险率越低,则意味着在给定时间内发生的事件越少。需要注意的是,危险率会随时间变化。 以下图表为例:
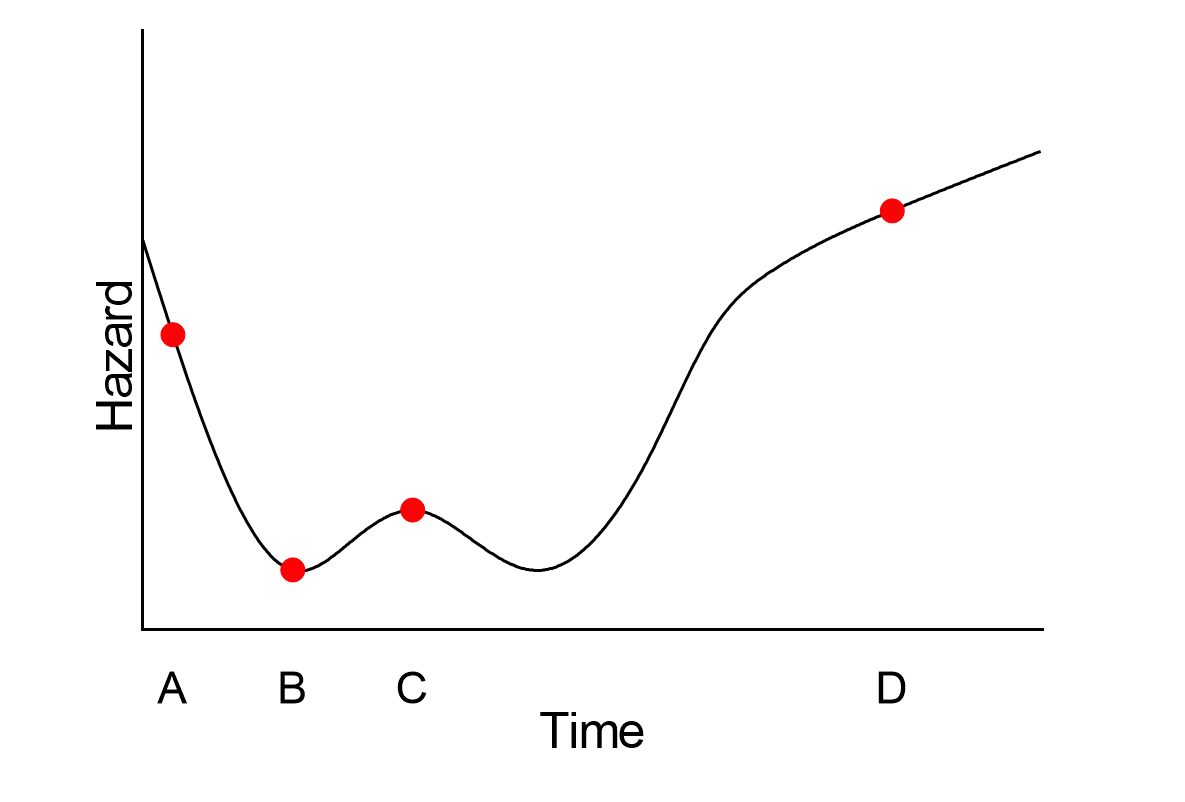
在此图中,危险率起初略高,随后在最初的一段时间内逐渐下降。接着,它上升至一个小峰值,然后再次下降,最后以不同的速率持续上升直至观察期结束。 对该图的解读是:在时间点A发生该事件的风险高于时间点B;在时间点C发生该事件的风险低于A,但高于B;而在时间点D发生该事件的风险则高于A、B或C。
虽然这张图表是理论性的,但它与人类预期寿命中的实际危险率确实存在一些相似之处。出生时,死亡的危险率实际上远高于出生后不久。该危险率在十几岁末至二十几岁末期间迅速上升(男女之间略有差异),随后随着时间的推移继续增加。
需要注意的是,危险率与事件发生时间信息之间的关系。如果将观测到的事件发生时间数据视为离散的(即事件只能发生在限定数量的时间点上),那么危险率的定义就相对简单。由 h(t) 表示的危险率定义为:
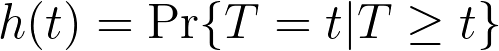
其中“T”是一个变量,表示事件可能发生的累计时间,而“t”表示特异性关注时间点。竖线“|”是概率符号,表示“在……的条件下”。 因此,通俗地说,危险率是指“在事件‘T’未在时间‘t’之前发生的前提下”,该事件在时间“t”发生的概率。然而,当时间被视为连续变量时(在生存分析中几乎总是如此),情况就会变得稍微复杂一些。 由于时间被视为连续变量,事件可能发生在任何给定的瞬间。在任何定义的时间窗口内,都存在无限多个可能的“瞬间”。根据微积分的性质,这意味着事件在任何一个特定瞬间(T=t)发生的概率实际上为零。 如果一开始不太能理解这一点,也无需过于担心,只需知道当时间被视为连续变量时(如在Cox比例风险回归中那样),计算风险率所需的数学推导会稍微复杂一些。
在后面的章节中,我们将通过相当多的数学推导来证明,危险率函数与生存函数之间存在直接关联。 不过,暂且不深入细节,需要了解的关键点是:建模危险率函数比直接建模生存函数更为简单和便捷。因此,Cox比例风险回归的目标是估计危险率函数。基于该危险率函数,可以推导出生存函数(以及生存率的估计值/预测值)。
