重要结果
P值
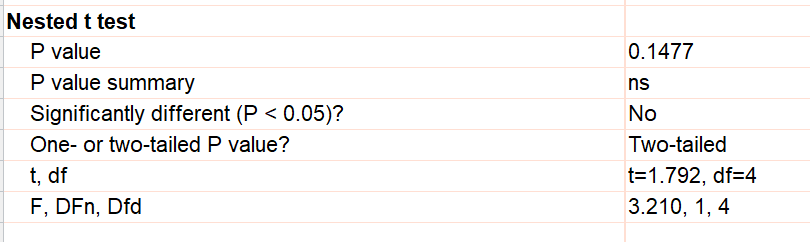
结果的呈现方式与非配对t检验类似。P值用于检验“两个处理组的均值相等”这一零假设。P值既可通过t比值(与非配对t检验对应)计算,也可通过F比值计算(因为此类数据通常采用嵌套方差分析进行分析)。 t 比值是 F 比值的平方根(因为分母自由度 df 为零),因此无论采用哪种方法,P 值都是相同的。我们同时展示这两种结果,以便您能与其他程序或文献进行对照
置信区间
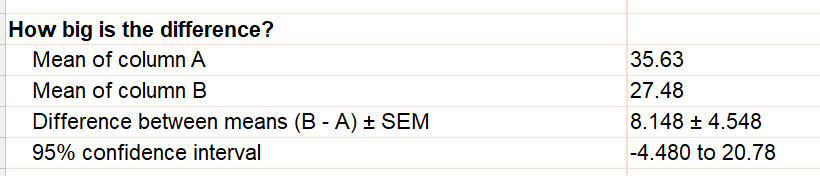
最重要的结果是两个均值之差的95%置信区间。如果您愿意,可以在对话框中选择90%或99%的置信区间。
其他结果(大多数科学家会忽略)
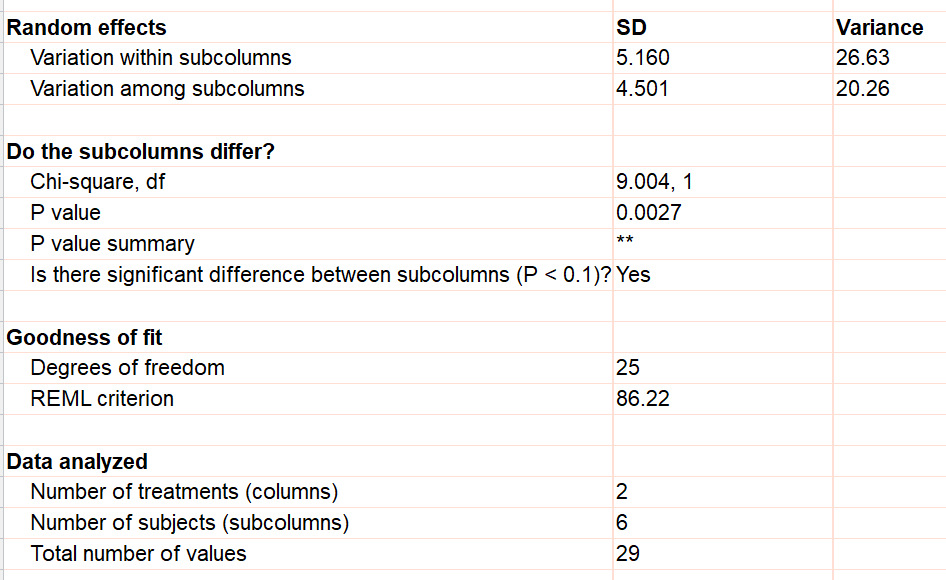
嵌套 t 检验拟合了一个混合模型。之所以称为混合模型,是因为假设子列中堆叠的值以及子列的选择是随机的,而处理因素(本示例中为教学方法)是固定的。这意味着我们关注的是这两种教学方法的检验,但学校的选择以及学校内的学生选择则是随机的。 我们并不关心那些特定的学生或特定的学校。该模型拟合了子列内部和子列之间的变异,并将这些结果分别报告为方差和标准偏差(即方差的平方根)。Prism 会报告这些数值,以便您与其他程序或教材进行比较。但这些数值其实帮助不大。
您将学生分配到不同的子列中,是因为您预期不同教室的结果会有所不同。Prism 检验的零假设是:实际上,同一列(教学方法)内的所有子列(学校)都是相同的。 此处的 P 值为 0.0027,因此您可以拒绝该零假设。该检验的实用价值有限。
Prism 可选地报告 REML 拟合优度值,以便与其他程序和教材保持一致。试图解读该值毫无意义。
