实验设计
您对对照组和处理组的大鼠中的一项变量进行了测量。每组有三只大鼠,每只大鼠进行了四次技术重复测量。请注意,每子列中堆叠的四个数值顺序是任意的。这四行数据没有时间序列关系,其顺序也没有其他特殊含义。
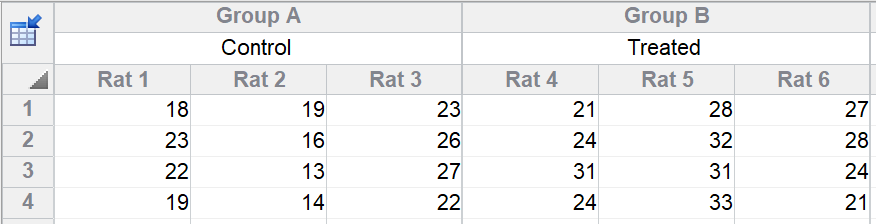
为什么这被称为嵌套设计?
该设计被称为嵌套设计,是因为每只大鼠要么属于对照组,要么属于处理组。您无法判断某些大鼠对治疗的反应是否优于其他大鼠,因为每只大鼠只接受了其中一种替代治疗。因此,大鼠被视为嵌套在处理组之中。
这也被称为分层设计。分层和嵌套是描述此类设计时的同义词。
错误的分析:对所有数据进行 t 检验
虽然将这些数据视为每个组中 n=12 样本的处理方式颇具诱惑力,但并不恰当。
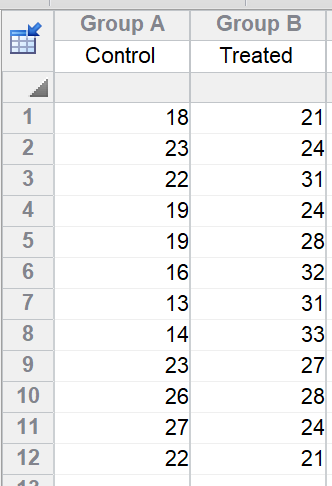
若对这些数据进行 t 检验,均值差的 95% 置信区间为 3.2 至 10.5,而检验“样本来自均值相同的总体”这一零假设的双侧 P 值为 0.0008。 这似乎是治疗增加了因变量的有力证据。但这些结果并没有实际意义。
为什么呢?因为t检验假设每个数值都提供独立的信息。这些数据虽然每个处理组包含三只独立的大鼠,但并不包含十二个独立的结局测量值。每只动物的重复测量值彼此之间的接近程度,要高于与其他动物获得的测量值之间的接近程度。 换言之,当您将三只重复实验的大鼠及其每只大鼠内的四个技术重复数据合并时,所得的12个值属于伪重复。若将伪重复数据当作实际重复数据进行分析,会得到过窄的置信区间和过小的P值。
错误的分析方法:双向方差分析
本页顶部所示的数据看似适合进行双向方差分析。但若运行双向方差分析,将导致结果不正确或具有误导性。 双向方差分析会假设第 2 行数据所对应的大鼠种类在某种程度上同时暴露于对照组和处理组条件下。但实际上,每个子列中值的顺序是任意的,因此将行作为“因素”在双向方差分析中进行检验是毫无意义的。
不使用嵌套t检验的替代分析方法(仅在样本量相等时有效)
如果没有缺失值,可以使用 t 检验分析数据。第一步是计算每只大鼠各技术重复的平均值。然后将这些均值填入新表格中,再通过非配对t检验比较两组均值。 请注意,在t检验中,每组的三只大鼠被堆叠在同一列中,而在嵌套t检验中,它们则并列在子列中。
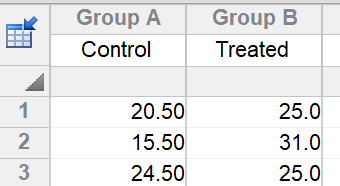
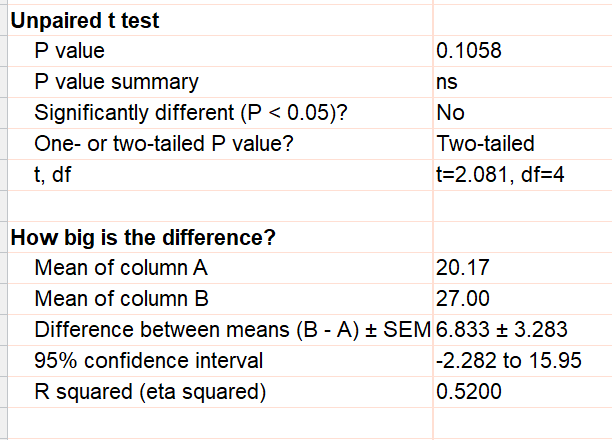
只要没有缺失值,这将得出正确的结果。 根据这一正确结果,差异的95%置信区间为-2.3至15.9,P值为0.1058。请注意,此处的结论(无证据表明存在治疗效应)与通过分析伪重复数据得出的错误结论截然不同。
Prism 中的嵌套 t 检验
Prism 8 引入了一项新的分析功能——嵌套 t 检验,该功能可一步完成分析,并能处理缺失值。它假设子列均值是从子列均值的高斯总体中抽样的,且子列内的重复数据也是从高斯总体中抽样的。 这两个高斯总体通常具有不同的标准偏差,Prism 会计算(估计)两者,并分别以标准偏差(SD)和方差的形式报告。
