对稳健回归的需求
非线性回归与线性回归一样,都假设数据在理想曲线周围的散布服从高斯分布或正态分布。这一假设导致了回归的常见目标:使各点与曲线之间的垂直距离(即Y值距离)的平方和最小化。 这种进行线性和非线性回归的标准方法被称为最小二乘回归。
实验误差可能会导致数值严重偏高或偏低的错误值——即异常值。即使只有一个异常值,也可能主导平方和的计算,从而导致误导性的结果。应对这一问题的一种方法是采用对高斯假设违背不敏感的方法,进行稳健拟合。 另一种方法是使用自动异常值剔除功能来识别并移除异常值,然后进行最小二乘回归。Prism 提供了这两种选择。 异常值识别方法实际上首先进行稳健拟合,从而获得一个基准线,据此判断某一点是否偏离该基准线过远,进而将其定义为异常值。随后,在移除这些异常值后,它会对剩余数据点进行标准的最小二乘拟合。
鲁棒回归的工作原理
根据《数值食谱》(1) 中的建议,我们基于以下假设构建了稳健拟合方法:曲线周围的变异服从洛伦兹分布,而非高斯分布。这两种分布都属于 t 分布族:
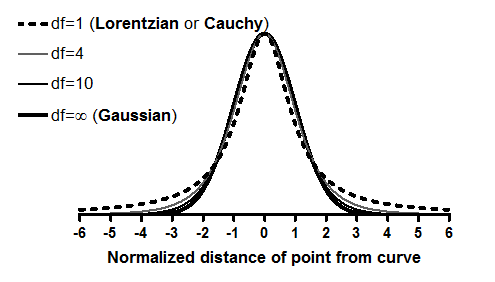
图中分布最宽的,即自由度 df=1 的 t 分布,也被称为洛伦兹分布或柯西分布。洛伦兹分布具有宽尾特性,因此异常值相当常见,因而对拟合结果的影响较小。
我们对马夸特(Marquardt)非线性回归算法进行了调整,以适应残差服从洛伦兹分布(而非高斯分布)的假设,具体细节详见参考文献2。
何时选择鲁棒非线性回归才是合理的?
在 Prism 中,稳健回归的主要用途是作为去除异常值的“基准”。您可以尝试使用稳健回归,以便更好地理解异常值去除方法(该方法以稳健回归为起点)。 如果您的唯一目标是根据标准曲线进行插值,且该标准曲线中包含一个或多个异常值,您可能会发现它很有用。
我们建议您在大多数情况下避免使用鲁棒回归(至少是 Prism 实现的版本),因为它存在以下缺点:
•稳健回归无法计算参数的标准误差或置信区间。
•稳健回归无法绘制置信带或预测带。
•稳健回归无法计算参数之间的相互关联程度。它无法计算协方差矩阵或依赖度值。
•稳健回归无法比较两个模型或两个数据集的拟合效果。
在大多数情况下,无法比较模型并不重要。但无法提供诊断信息(标准误、置信区间、协方差矩阵、依赖度、置信带和预测带)这一缺陷,严重限制了鲁棒回归在大多数研究中的实用性。
参考文献
1.Press WH, Teukolsky SA, Vettering WT, Flannery BP: 《C语言数值配方:科学计算的艺术》。纽约州纽约市:剑桥大学出版社;1988年。
2.Motulsky HM 和 Brown RE,《使用非线性回归拟合数据时检测异常值——一种基于稳健非线性回归和错误发现率的全新方法》,《BMC生物信息学》2006,7:123。下载PDF版本。
