ROUT 异常值剔除方法的工作原理
Prism 提供了一种独特的识别和去除异常值的方法,详见参考文献 1。由于该方法结合了鲁棒回归和异常值去除,因此我们将其称为 ROUT 方法。
ROUT 回归方法的步骤如下。
1.我们采用鲁棒非线性回归方法拟合一条不受异常值影响的曲线。
2.分析稳健拟合的残差以识别任何异常值。此步骤采用了一种新的异常值检验方法,该方法改编自用于多重比较检验的“错误发现率(FDR)”方法。
3.剔除异常值,并对剩余数据进行普通最小二乘回归。
如何在 Prism 中使用 ROUT 方法
尽管 ROUT 方法需要三个步骤(如上所述),但 Prism 会自动完成所有这些操作。您只需在非线性回归对话框的“拟合”选项卡上勾选一个选项即可:
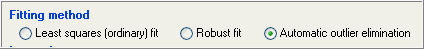
随后,Prism 将识别出异常值,将其剔除,并对剩余数据点进行拟合。异常值将显示在单独的表格中,异常值的数量则会统计在主结果表中。
ROUT系数Q
Q 的数值决定了 ROUT 法判定异常值的严格程度。相关的数学细节在参考文献 1 中有详细说明。该数值可在“非线性回归”对话框的“方法”选项卡中设置。
若将 Q 设为较高值,定义异常值的阈值将不那么严格。这意味着 Prism 的异常值检验力会增强,但同时也会更频繁地将正常数据误判为“异常值”。
若将 Q 设置为较低值,定义异常值的阈值将更严格。这意味着 Prism 的异常值检验力会减弱,但将某一点错误地定义为异常值的可能性也会降低。
除非您有充分理由选择其他设置,否则我们建议保留默认值 1%。我们的模拟结果表明,如果所有数据点都服从高斯分布,Prism 将在约 2-3% 的实验中错误地检测出一个或多个异常值。 这并不意味着所有值中有几个百分比会被判定为异常值,而是指在几个百分比的实验中会检测到一个或多个异常值。如果数据中确实存在异常值,Prism 将在错误发现率低于 1% 的情况下检测到它们。
非等权重、稳健回归与异常值剔除
正如我们在参考文献 1 中所解释的,不均匀加权在鲁棒回归中并无用处。问题在于,异常值可能会被赋予过高的权重。鲁棒回归本质上是应用差异权重,因此再添加另一种加权方案就没有意义了。
因此,如果您同时选择了不均匀加权和稳健拟合,Prism 将假设所有数据点权重相等来进行拟合。但在生成残差表时,它仍会采用您设定的加权方案。
如果您同时选择了不均匀加权和自动异常值剔除,Prism 会首先使用稳健拟合进行拟合(忽略您的加权选择)。如参考文献 1 所述,在识别异常值时,它确实会使用加权因子。随后,它会对已剔除异常值的数据执行加权非线性回归。
参考文献
1.Motulsky HM 和 Brown RE,《使用非线性回归拟合数据时检测异常值——一种基于稳健非线性回归和错误发现率的全新方法》,《BMC Bioinformatics》2006,7:123。
