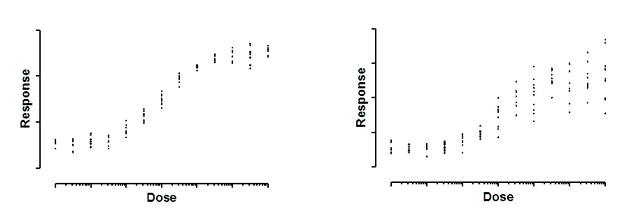
上面的两幅图均显示了剂量反应曲线,其中每个反应点均通过十个重复测量值来测定反应。 在左侧图表中,这些重复测定值的标准偏差保持一致,在整个曲线范围内基本相同。在右侧图表中,重复测定值的标准偏差与Y值相关。随着曲线上升,重复测定值之间的变异性也随之增加。
这些数据是模拟生成的。在两种情况下,重复测量值之间的离散程度均来自高斯分布的抽样。在左侧图表中,该高斯分布的标准差对于所有剂量而言都是相同的。 在右侧图中,标准偏差是平均Y值的恒定比例。当一个响应值是另一个响应值的两倍时,重复实验之间的标准偏差也是其两倍。换言之,变异系数(CV)是恒定的。
如果对右侧数据拟合模型时,未考虑到随着Y值增大,离散程度也会随之增加,会发生什么情况? 考虑两种剂量,它们产生的响应值相差一倍。对于响应值较高的剂量,重复测量值与真实曲线的平均距离将是较高响应值情况下的两倍。 由于回归分析旨在最小化这些距离的平方和,因此预计这些点的平方和贡献量将是平均 Y 值较小点数的四倍。换言之,平均 Y 值是另一组两倍的重复测量数据集,其权重将被赋予四倍之多。 这本质上意味着,曲线拟合过程将更加努力地使曲线靠近这些数据点,而相对忽略Y值较低的数据点。若要使两组对平方和的贡献相等,低Y值组的数据重复次数需要增加四倍。
加权的目的是让曲线上任何位置的数据点对平方和的贡献都相等。 当然,随机因素会导致某些数据点的离散程度高于其他数据点。但加权的目标是使这些差异完全由随机性决定,与 Y 值无关。“权重”这一术语有些误导性,因为目标恰恰是去除高 Y 值数据点上的额外“权重”。其真正目标其实是“去权重”。
Prism 在非线性回归的“方法”选项卡中提供了六种选择,并允许您测试哪种加权方式更为合适。
