“Cox比例风险回归分析参数”对话框中的“图表”选项卡用于生成图表,以直观地展示特定组别随时间变化的估计生存概率。 需要注意的是,这些估计的生存曲线是根据分析中定义的“模型”(MODEL)生成的,并不代表使用选定数据进行卡普兰-迈尔生存分析时生成的生存曲线。 相反,这些生存曲线是基于Cox回归的一个关键假设生成的:具体来说,即任何个体(或由一组预测变量定义的个体群体)的危险率与某种基线危险率成正比。 这一假设的后果是,所有估计的生存曲线都将具有相同的基本形状(包括它们都在相同的时间点出现“阶跃”这一事实)。这是因为每条估计的生存曲线都是基于基线生存率(本页已讨论)计算得出的。 对于具有特异性预测变量集的给定个体/群体,其估计生存率与基线生存率之间的关系可表示为:
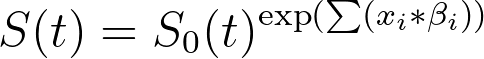
除了使用参数估计值外,该方程还可以利用每个预测变量的风险比进行重写:
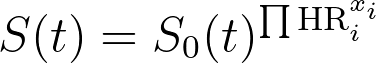
本质上,这意味着对于给定的个体或组(模型中预测变量的取值已指定),其在所有时间点的估计生存率将相对于基线生存率成比例地更高或更低。 改变预测变量的数值不会改变估计生存曲线的整体形状,只会改变新估计生存曲线与已确定的基线生存曲线之间的比例关系。
在指定 Prism 生成估计生存曲线时应使用的预测变量时,有两个概念需要牢记:
•如果未指定某个预测变量,则生成估计生存曲线时会假设该变量取其基线值
•Prism 将自动确定所指定预测变量值的所有可能组合,并针对每种组合生成一条估计生存曲线
考虑一个将年龄作为连续预测变量纳入的模型(未先对数据进行中心化处理)。该变量的基线值为零(因为它是连续变量)。在生成估计生存曲线时,如果未指定年龄的数值,生成的曲线将代表年龄等于零时的估计生存率。 在大多数情况下,这可能意义不大(例如,体重或身高为零的情况也是如此)。因此,如果某个连续变量被识别为模型中的重要预测变量,在指定估计生存曲线时,应考虑为该变量指定一个数值。
当使用分类变量指定估计生存曲线时,可能存在许多不同的水平组合,这些组合可定义不同的组别。考虑两个分类变量:
•性别,两个水平“女性”和“男性”
•治疗组(Treatment_Group),三个水平:“对照组”、“标准治疗”和“实验治疗”
利用这两个分类变量,可以定义六个不同的组:
1.对照组中的女性
2.标准治疗组中的女性
3.实验治疗组中的女性
4.对照组中的男性
5.标准治疗组中的男性
6.实验治疗组的男性
无需手动定义这六种组合,只需在参数对话框中选择两个变量(并为每个变量选择相应的水平),Prism 就会自动确定绘图所需的独立估计生存曲线数量。 在本示例中,如果添加第三个变量“血糖浓度”(其水平为“低”、“中”和“高”),组合总数将增加到 18 个。但使用 Prism 时,您只需选择这三个变量(及其水平),而无需手动指定所有 18 种不同的组合。
