实现降维主要有两种方法:特征选择和特征提取。 不必过分纠结于此处的“特征”一词。在机器学习领域(PCA主要应用于此),“特征”一词仅指可测量的属性,通常与“预测因子”互换使用。在Prism中,您也会看到它们被简称为“变量”。
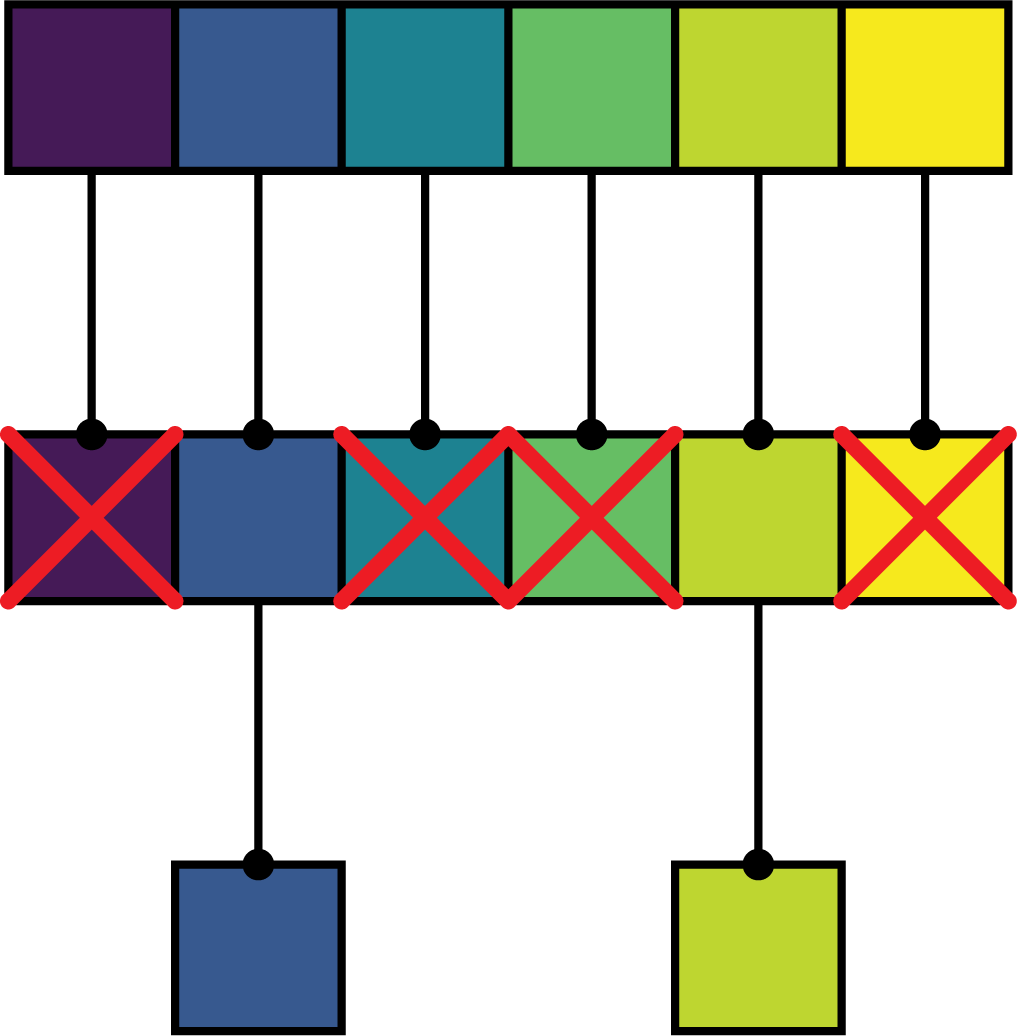
特征选择与特征提取的主要区别在于对数据集中原始变量的处理方式。在特征选择中,最初会考虑所有变量,然后根据特异性标准剔除部分变量。 剩余的变量可能会经历多轮额外筛选,但一旦过程完成,所选变量与原始数据中的呈现形式保持不变。
特征选择只是从原始变量中挑选出“最重要的”变量,并舍弃其余变量。一些经典的特征选择技术(尤其是逐步选择、前向选择或后向选择)通常被认为是不明智的,因此 Prism 目前不提供任何形式的自动特征选择技术。
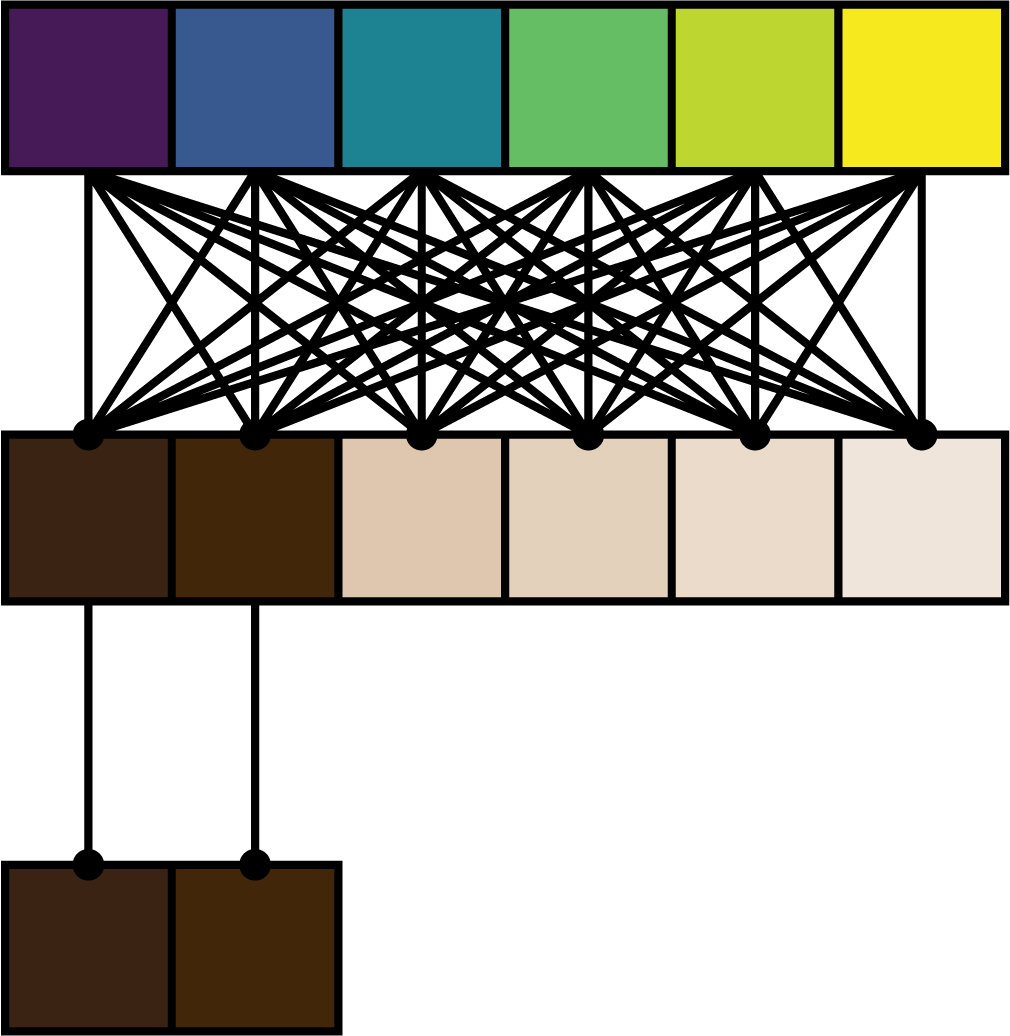
相比之下,特征提取是利用原始变量构建一组新的变量(或特征)。 从原始变量推导出这些新特征的方法可以是线性的,也可以是非线性的。主成分分析(PCA)是特征提取中最常用的线性方法。采用这种方法时,PCA 利用原始变量的线性组合来推导出一组新的特征(在 PCA 中,我们将这些新特征称为主成分,或 PC)。
要理解线性组合,不妨参考以下水果潘趣酒配方:
水果潘趣酒
8 杯蔓越莓汁
3 杯菠萝汁
3 杯橙汁
¼ 杯柠檬汁
4 ¼ 杯姜汁汽水
另一种看待此配方的方式是将其视为原料(变量)的线性组合:
水果潘趣酒 = 8*(蔓越莓汁) + 3*(菠萝汁) + 3*(橙汁) + 0.25*(柠檬汁) + 4.25*(姜汁汽水)
每个变量都乘以一个常数(系数),然后将各乘积相加。 PCA 通过生成由原始变量线性组合而成的主成分(PCs)来执行类似的过程。PCA 真正关键的部分在于这些主成分的定义方式,它能够将原始数据投影到低维空间,同时将信息损失降至最低。
下图总结了特征选择(消除原始变量)与特征提取(将原始变量组合形成新变量)之间的区别,随后利用包含最有价值信息的新变量将数据投影到低维空间中。
特征选择
特征提取