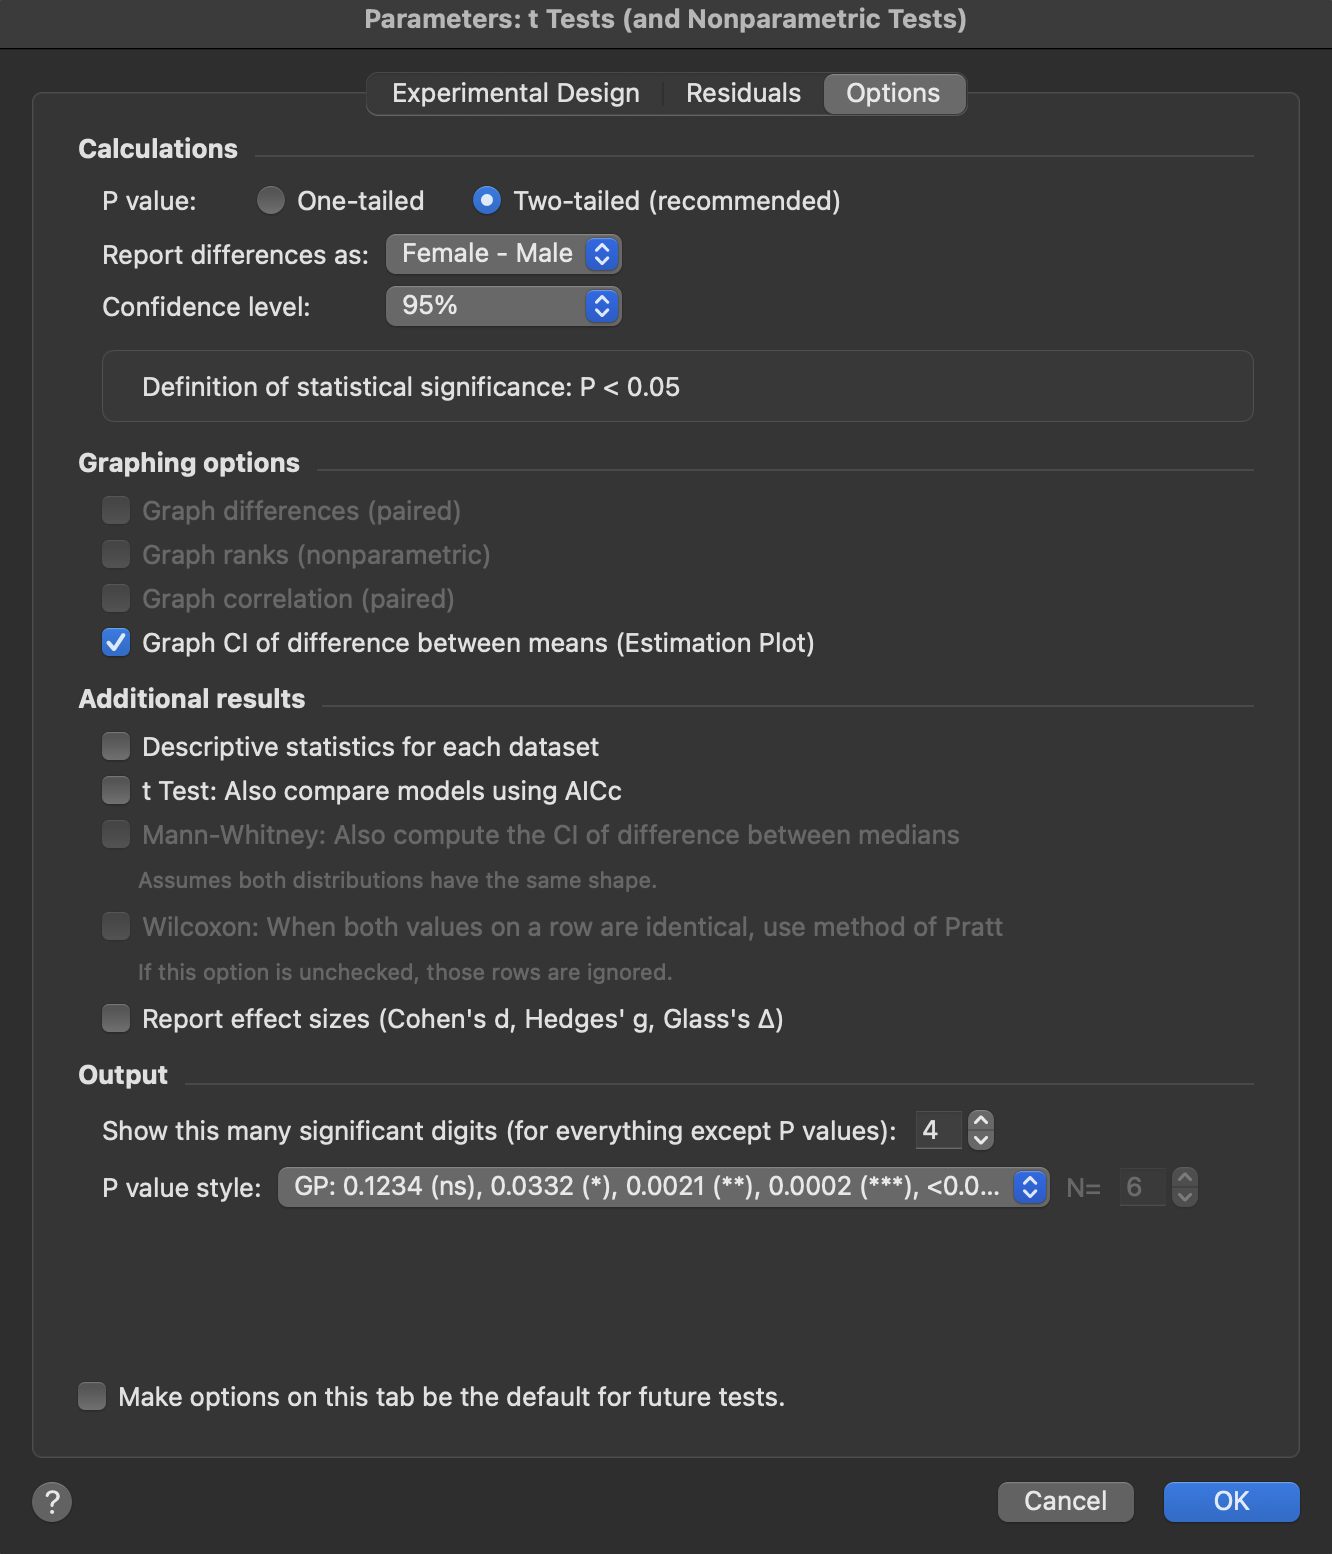
此选项卡上的选项会根据您在第一个选项卡中选择的测试而略有不同。
计算
对于大多数用户而言,计算选项的默认设置已足够(双尾P值、95%置信区间,以及将第一列减去第二列来计算差异)。
•单尾P值或双尾P值。除非有充分理由不这样做,否则请选择双尾P值。
•“以…形式报告差异”。此选项决定 Prism 报告均值或中位数之间差异的正负号。您是希望用第二个均值减去第一个均值,还是用第一个均值减去第二个均值?
•置信水平。95%是标准值,但您可以选择其他置信水平。系统接受0.01%至99.99%之间的十进制值,因此您可以使用比通常的α = 0.05或α = 0.01更严格的阈值。 例如,输入 99.9 可使用 99.9% 的置信水平,对应 α = 0.001。
绘图选项
本节中可用的选项依赖于您在第一个选项卡中选择的检验类型。这些选项有助于更深入地查看数据,但对于初学者而言,除“估计图”外,其余选项均非必需。
•绘制差值(配对)或绘制 log(比值)。配对t检验和Wilcoxon配对检验首先计算每行两个值之间的差值。此选项将生成一个表格和图表,显示这些差值的列表。 在执行比率配对t检验时,此选项可生成成对值比率对数图(请注意,两个值的比率对数在数学上等同于这两个值对数的差)。
•绘制秩(非参数)。 Mann-Whitney检验首先将所有值按从小到大的顺序排序,然后比较两组的平均秩。此选项将生成一个表格和图表,展示这些秩值。威尔科克斯检验首先计算每对值之间的差值,然后对这些差值的绝对值进行排序,当差值为负时赋予负值。
•相关性图(配对)。若假设正态分布,该图将绘制一组数据与另一组数据的对比,以直观评估它们之间的相关程度。若假设对数正态分布,则绘制各组数据对数的分布图。
•均值差的置信区间图(估计图)。此选项将生成一个包含原始数据散点图(或小提琴图)的图表。 此外,该图表还包含第三组数据集,绘制均值差及其95%置信区间(针对非配对检验),或差值的均值及其95%置信区间(针对配对检验)。 估计图对于直观评估 t 检验结果非常有用。请阅读更多关于如何理解和使用估计图的内容。请注意,如果假设数据服从对数正态分布,这些选项会略有不同。
o对于采用对数正态分布的非配对设计,将生成一个估计图,其中绘制各组值的对数及其对数平均值(对该平均值取指数可得各组的几何均值)。 此外,还提供第三组图,绘制各组平均值对数之间的差值及其 95% 置信区间。对该值取指数可得两组几何均值的比值。
o对于对等设计且服从对数正态分布的情况,该图仅显示配对比值的几何均值及其95%置信区间
其他结果
这些选项默认未被选中。AIC 选项仅用于特殊目的。其他选项即使对初学者也可能有所帮助。
•描述性统计。选中此选项后,Prism 将为每个数据集生成新的描述性统计表。
•还可使用 AICc 比较模型。由于这并非标准做法,大多数用户通常不会使用此选项。非配对t检验本质上是比较两个模型对数据的拟合程度(一个共享均值与两个非配对组平均值的对比)。 t 检验的计算等同于额外平方和F检验。勾选此选项后,Prism 不仅会报告常规的 t 检验结果,还会通过 AICc 比较两个模型的拟合度,并报告每个模型正确的概率百分比。
•非参数检验。计算中位数之差(Mann-Whitney检验)或配对差值的中位数(威尔科克斯顿检验)的 95% 置信区间。 只有在做出一个解读 P 值时不需要的额外假设时,才能对该置信区间进行解读。对于Mann-Whitney检验,必须假设两个总体具有相同的分布形状(无论该形状如何)。 对于威尔科克斯顿检验,必须假设差值的分布是对称的。当统计分析结果附有置信区间时,其实用性无疑会更高,因此值得考虑您是否愿意接受这些假设。计算细节。
•威尔科克斯顿检验。当一行中的两个配对值完全相同时会发生什么?Prism 5 按照威尔科克斯顿在创建该检验时所描述的方式处理此情况。Prism 还提供了使用普拉特(Pratt)方法的选项。如果您的数据中存在大量并列值,建议您阅读关于这两种方法的说明,并决定采用哪一种。
•报告效应量(Cohen's d、Hedges' g、Glass's Δ)。勾选此选项可计算标准化效应量,用于量化组间差异的大小。
t 检验的标准化效应量
本节所述的功能仅在 Prism Pro 或 Prism Enterprise 订阅中提供。 |
在使用 t 检验比较两个组时,P 值可告知差异是否统计学显著,但无法说明该差异的大小或意义。 效应量提供了衡量组间差异幅度的标准化指标,使您能够更轻松地解读结果的实际意义,并比较不同研究之间的发现。Prism 为 t 检验计算了多种互补的效应量指标。
R 平方(eta 平方)
R²(在 t 检验中也称为 eta²)代表因组别归属而解释的因变量方差所占的比例。其取值范围为 0 到 1,其中 0 表示组别归属未解释任何方差,1 表示解释了全部方差。 例如,R²值为0.14意味着,通过确定数据值所属的组别,可以解释数据中14%的变异,而剩余的86%则归因于组内个体差异。该指标与t统计量直接相关,并提供与方差分析(ANOVA)中eta²相同的信息。
科恩d值
Cohen's d 用标准偏差单位表示组平均值之间的差异。其计算方法是将均值之差除以合并标准偏差。Cohen 提出了以下解读指南:
•小效应:d ≈ 0.20
•中等效应:d ≈ 0.50
•大效应:d ≈ 0.80
例如,科恩d值为0.73,意味着两个组的组平均值相差0.73个标准偏差。这属于中等偏大的效应,表明其不仅具有统计学显著性,还具有相当大的实际意义。
赫奇斯g
赫奇斯 g 是科恩 d 的一种变体,用于校正小样本量带来的偏差。在样本量较大时,这种校正作用微乎其微,但在样本量较小(每组少于 20 人)时则变得尤为重要。 在发表论文时,通常更倾向于使用赫奇斯g而非科恩d,因为它能提供更准确的估计值,特别是在小样本情况下。其解读准则与科恩d相同。
格拉斯Δ(delta)
格拉斯的Δ(delta)与科恩的d类似,但仅使用对照组的标准偏差作为分母,而非将两组数据合并计算。这在以下情况下特别有用:
•两组的变异性差异很大
•将实验组与已确立的对照组进行比较
•干预措施可能不仅影响均值,还会影响变异性
格拉斯δ的解读准则与科恩d相同。
效应量的选择与解读
对于大多数应用场景,我们建议报告赫奇斯g值,因为它能提供最精确的估计,特别是在小样本量情况下。不过,这三种标准化效应量(d、g和Δ)在描述效应大小方面所传达的信息大同小异,且均采用相同的解读准则。
在以下情况下,效应量尤为重要:
•您发现统计学显著差异,但希望了解其是否具有实际意义
•您正在比较采用不同测量量表的各项研究结果
•您正在规划未来研究,并需要估算检测特定效应量所需的样本量
•您正在进行荟萃分析,整合多项研究的结果
请记住,即使效应量较大,也不一定意味着该差异在您的特异性情境下具有重要性;而较小的效应量仍可能具有科学或临床意义。解读效应量时,应始终结合您的研究问题和研究领域来综合考虑。
