什么是计划内比较?
“计划内比较”这一术语用于描述将研究重点集中在少数几个在科学上合理的比较上的情况。您不会进行所有可能的比较,也不会先查看数据再决定进行哪些比较。相反,您会作为实验设计的一部分,决定仅进行少数几个比较。
一些统计学家建议,当仅进行少数计划内比较时,无需对多重比较进行校正。其理由是,由于研究设计聚焦明确,因此可获得一定的额外功效作为回报。
Prism 始终会对多重比较进行校正,无论这些比较是预先计划的还是事后进行的。但一旦您意识到,当仅需比较一对均值时,计划内比较与针对选定均值对的 Bonferroni 校正比较完全相同,您就可以让 Prism 为您自动进行计划内比较。
分析错误的示例数据
在下图中,第一列显示控制数据,第二列显示经处理后的数据。该实验旨在验证处理是否改变了测得的活性(Y轴所示)。 为确保溶剂(用于溶解处理物的溶剂)不会影响结果,实验还设置了另一组不含溶剂的对照组(第三列)。为确保实验正常进行,还收集了非特异性(空白)数据,并显示在第四列中。
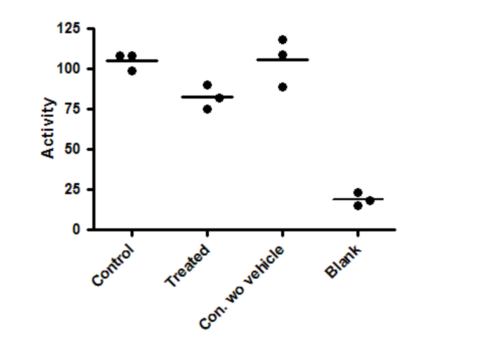
以下是单向方差分析以及图基多重比较检验的结果,这些检验将每个组与其他所有组进行了比较。
One-way analysis of variance |
|
|
|
|
P value |
P<0.0001 |
|
|
|
P value summary |
*** |
|
|
|
Are means signif. different? (P < 0.05) |
Yes |
|
|
|
Number of groups |
4 |
|
|
|
F |
62.69 |
|
|
|
R squared |
0.9592 |
|
|
|
|
|
|
|
|
ANOVA Table |
SS |
df |
MS |
|
Treatment (between columns) |
15050 |
3 |
5015 |
|
Residual (within columns) |
640 |
8 |
80 |
|
Total |
15690 |
11 |
|
|
|
|
|
|
|
Tukey's Multiple Comparison Test |
Mean Diff. |
q |
P value |
95% CI of diff |
Control vs Treated |
22.67 |
4.389 |
P > 0.05 |
-0.7210 to 46.05 |
Control vs Con. wo vehicle |
-0.3333 |
0.06455 |
P > 0.05 |
-23.72 to 23.05 |
Control vs Blank |
86.33 |
16.72 |
P < 0.001 |
62.95 to 109.7 |
Treated vs Con. wo vehicle |
-23 |
4.454 |
P > 0.05 |
-46.39 to 0.3877 |
Treated vs Blank |
63.67 |
12.33 |
P < 0.001 |
40.28 to 87.05 |
Con. wo vehicle vs Blank |
86.67 |
16.78 |
P < 0.001 |
63.28 to 110.1 |
总体方差分析(ANOVA)的P值非常低,因此可以拒绝“所有数据均来自组平均值相同的组”这一零假设。但这其实并没有什么帮助。 第四列是阴性对照组,因此其数值自然远低于其他组。方差分析的P值回答了一个其实无需探讨的问题。
采用Tukey多重比较检验对所有均值两两进行了比较(见上表)。您只关注第一组比较——对照组与处理组——而该比较在统计学上不显著(P>0.05)。
这些结果并未真正回答您实验最初设定的问题。Tukey多重比较检验将5%的显著性水平应用于全部六组比较。但这六组比较中有五组并未涉及具有科学意义的问题。您本就预期空白组的数值会远低于其他组。 如果情况并非如此,您根本不会费心进行分析,因为实验就没成功。同样地,如果使用载体(第一列)的对照组与未使用载体(第三列)的对照组存在显著差异,您也不会费心分析其余数据。 这些是控制测量,旨在确保实验系统正常运行。将它们纳入方差分析(ANOVA)和后检验中,只会降低您检测所关注差异的功效。
包含计划内比较的示例数据
由于这里您只关注一项比较,因此只比较对照组和处理组的数据是合理的。
在 Prism 的单向方差分析(ANOVA)对话框中,选择“在选定的列对之间进行 Bonferroni 比较”,并仅选择一对列。
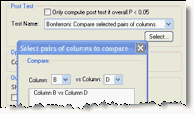
该差异在统计学上具有显著性(P<0.05),且均值差异的95%置信区间为5.826至39.51。
在报告结果时,请务必说明您的P值和置信区间未经过多重比较校正,因此这些P值和置信区间仅适用于您报告的每个具体数值,而不适用于整个比较族。
在本示例中,我们计划仅进行一次比较。若计划进行多次比较,请选择费舍尔最小显著差法(Fisher's LSD)来进行多重比较。在报告结果时,请务必说明您进行的是计划内比较,因此未对 P 值或置信区间进行多重比较校正。
通过 t 检验分析的示例数据
计划内比较分析依赖于方差分析(ANOVA)的假设,包括所有数据均采自离散程度相同的组这一假设。因此,即使您只想比较两个组,仍需使用所有组的数据来估计组内离散程度,从而获得更多的自由度,进而提高功效。
在此情境下,该假设似乎值得怀疑。空白组的离散程度小于对照组和处理组样本。另一种方法是完全忽略控制数据(在利用对照组验证实验有效性之后),并使用t检验来比较处理组与对照组的数据。 t 比值是通过将均值之差(22.67)除以该差值的标准误差(5.27,由两个标准偏差和样本量计算得出)来计算的,因此等于 4.301。被比较的两个组中共有六个数据点,因此自由度为四。 P值为0.0126,两个均值之差的95%置信区间为8.04至37.3。
计划内比较的计算方法
首先计算第1组与第2组之间差异的标准误差。 计算方法如下,其中 N1 和 N2 分别是待比较两组的样本量(本示例中均为 3),MSresidual 是一元方差分析(单向方差分析)报告的残差均方(本示例中为 80.0):
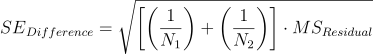
或者等效地
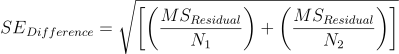
在本示例中,第1列与第2列均值之差的标准误差为7.303。
现在计算 t 比值,即均值之差(22.67)除以该差值的标准误差(7.303)。 因此 t=3.104。由于标准误 (MSerror) 是根据所有数据计算得出的,其自由度数与方差分析表中的残差自由度数相同,在本示例中为 8(总值数减去组数)。相应的 P 值为 0.0146。
95%置信区间从观测均值开始,其范围等于差值的标准误(7.303)乘以95%置信水平、8自由度的t分布临界值(2.306)。 因此,该差异的95%置信区间范围为5.826至39.51。
