边进行研究边确定样本量的吸引力
对许多人来说,在研究开始前计算样本量似乎是一件麻烦事。为什么不在收集数据的同时进行分析呢?如果结果不具有统计学显著性,那就再收集一些数据,然后重新分析;如果结果具有统计学显著性,那就停止研究,不要再浪费时间和金钱去收集更多数据了。
这种方法的问题在于:如果您不喜欢结果,就会继续进行;但如果您喜欢结果,就会停止。其后果是,如果零假设成立,获得“显著”结果的概率将远高于5%。
通过模拟展示未预先确定样本量所带来的风险
下图通过模拟演示了这一点。我们从高斯分布(均值=40,标准差=15,但这些数值是任意的)中抽取值来模拟数据。两个组均采用完全相同的分布进行模拟。 我们为每个组选取N=5,计算了非配对t检验并记录了P值。随后,我们向每个组各增加一名受试者(即N=6),并重新计算t检验和P值。 我们重复这一过程,直到每组样本量达到N=100。随后,我们将整个模拟过程重复了三次。这些模拟都是在两个组平均值完全相同的组之间进行的。因此,我们获得的任何“统计学显著”的结果都必然是巧合——即Ⅰ类错误。
该图以P值为Y轴,样本量(每组)为X轴。图底部的绿色阴影区域表示P值小于0.05的情况,因此被视为“统计学显著”。
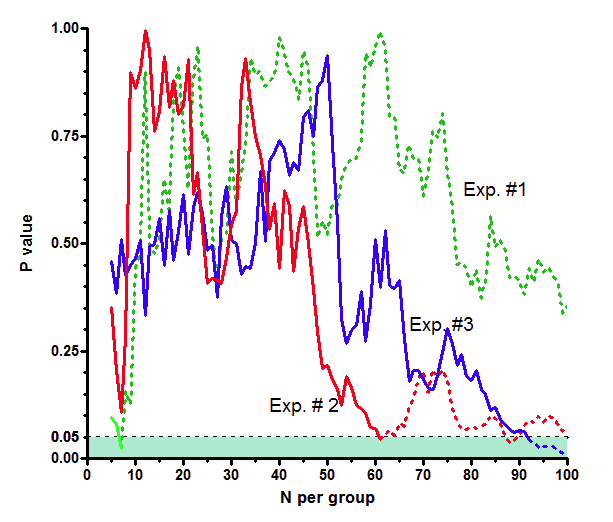
绿色曲线显示了第一组模拟实验的结果。当N=7时,其P值小于0.05,但在其他所有样本量下,P值均大于0.05。 红色曲线显示了第二组模拟实验的结果。当N=61时,以及当N=88或89时,其P值均小于0.05。蓝色曲线代表第三组实验。当N=92至N=100时,其P值均小于0.05。
如果我们采用序贯法,就会将这三项实验的结果均判定为“统计学显著”。在绿色实验中,我们会在 N=7 时终止实验,因此永远不会看到其曲线中的虚线部分。 我们会于红色实验的 N=61 时终止,蓝色实验的 N=92 时终止。在这三种情况下,我们都会将结果判定为“统计学显著”。
由于这些模拟是针对两个总体真实均值完全相等的值生成的,因此任何“统计学显著性”的判定都属于Ⅰ类错误。 如果零假设成立(两个总体的均值相同),我们预计在5%的实验中会出现此类Ⅰ类错误(若采用传统定义α=0.05,即P值小于0.05被判定为显著)。 但采用这种序贯方法,我们三项实验均产生了Ⅰ类错误。如果将实验持续进行足够长的时间(样本量趋于无穷大),所有实验最终都会达到统计学显著性。 当然,在某些情况下,即使没有“统计学显著性”,您最终也会放弃。但这种序贯方法会在远高于5%的实验中产生“显著”结果,即使零假设为真,因此该方法是无效的。
结论
关键在于您必须确定样本量并坚持到底。 如果您在喜欢结果时就停止,而在不喜欢结果时却继续进行,您就是在自欺欺人。如果当结果不具有统计学显著性时继续进行实验,而当结果具有统计学显著性时却停止,那么错误地得出结果具有统计学显著性的概率将远高于5%。
有一些特殊的统计技术用于序贯分析数据:当结果模糊拟合时增加受试者数量,当结果明确时停止实验。请查阅高级统计学书籍中的“序贯医学试验”相关内容以了解更多信息。
