什么是依赖度?
当模型包含两个或更多参数时(这种情况几乎总是存在的),这些参数之间可能存在相互关联。
参数相互关联意味着什么?在拟合模型后,改变其中一个参数的值,但保持其他参数不变。此时,曲线会偏离数据点。 现在,尝试通过调整其他参数,使曲线重新靠近数据点。如果能使曲线更接近数据点,则说明这些参数之间存在相互依赖关系;如果能将曲线恢复到原位置,则说明这些参数是冗余的。
Prism 可以通过报告相关矩阵或依赖度来量化参数之间的关系。
解读依赖度
即使不了解依赖度的具体计算方法,您也可以对其进行解读。如果您想了解该值的计算过程,请继续阅读。
依赖度计算示例
本示例为指数衰减(摘自《MLAB应用手册》第128-130页,www.civilized.com。
时间 信号 1.0 39.814 2.0 32.269 3.0 29.431 4.0 27.481 5.0 26.086 6.0 25.757 7.0 24.932 8.0 23.928 9.0 22.415 10.0 22.548 11.0 21.900 12.0 20.527 13.0 20.695 14.0 20.105 15.0 19.516 16.0 19.640 17.0 19.346 18.0 18.927 19.0 18.857 20.0 17.652 |
|
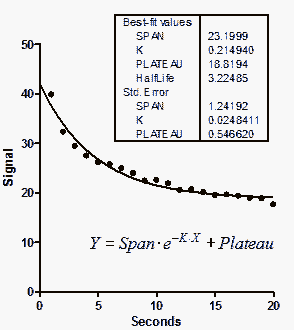
我们将重点关注速率常数 K。控制数据为 0.2149 sec⁻¹,对应的半衰期为 3.225 秒。 其标准误差为 0.0248 sec⁻¹,对应的 95% 置信区间为 0.1625 至 0.2674 sec⁻¹。
显然,这三个参数并非完全独立。如果强行将 K 设为较高的值(衰变更快),曲线就会与数据点越拉越远。但可以通过让曲线从较高的值开始,以较低的值结束(增加“跨度”并减少“平台期”)来稍作补偿。 各参数的标准误差值之间的依赖度。
将“跨度”和“平台期”固定为其最佳控制数据,并让 Prism 仅对速率常数 K 进行拟合。当然,由于我们已将“跨度”和“平台期”固定为最佳控制数据,这不会改变最佳控制数据。但 K 的标准误差现在更低,为 0.008605。这合乎逻辑。 当固定“Span”和“Plateau”时,改变 K 的值对拟合优度(平方和)的影响,比允许“Span”和“Plateau”的值也随之变化以补偿 K 的变化时更大。
当固定其他参数时,K 的标准误值较低,这表明 K 的不确定性取决于其他参数。我们需要通过计算依赖度来量化这一点。
在比较这两个标准误差值之前,我们需要先纠正一个小问题。计算标准误差时,程序会除以自由度(df)的平方根。对于每次拟合,df 等于数据点数减去回归拟合的参数数。 因此,对于完整拟合,df等于20(数据点数)减去3(参数数),即17。当我们固定Plateau和Span的值时,仅有一个参数,因此df=19。由于df不相同,这两个标准误差值并不完全可比。 当其他参数被固定时,标准误(SE)的数值被人为地压低了。这很容易修正。将两个参数受约束时报告的标准误乘以 19/17 的平方根。这一修正后的标准误等于 0.00910。
现在我们可以计算依赖度。它等于 1.0 减去两个(修正后)标准误差值之比的平方。 因此,本示例中的依赖度等于 1.0 减去 (0.0091/0.0248)²,即 0.866。本质上,这意味着 K 的方差中有 86.6% 源于其与其他参数的交互作用。
每个参数都有独特的依赖度(除非只有两个参数)。Span的依赖度为0.613,Plateau的依赖度为0.813。
依赖度概念的起源
似乎没有论文可以引用,说明“依赖度”这一概念首次被使用的情况。依赖度的概念显然是由美国国立卫生研究院(NIH)的迪克·施拉格(Dick Shrager)提出的,随后由加里·诺特(Gary Knott)加以完善。MLAB是首个计算依赖度的软件,其手册中对此有详细说明。GraphPad Prism只是按照手册中的说明直接实现了该方法。 (我是在2007年收到加里·诺特的一封电子邮件中了解到这段历史的)。这里有一篇早期论文讨论了依赖度的基本概念,但其定义有所不同(取值范围为1到无穷大,而非0到1,且数学推导未作充分说明)。
