额外平方和F检验用于比较嵌套模型
额外平方和F检验用于比较两个替代性嵌套模型的拟合优度。“嵌套”意味着一个模型是另一个模型的简单模型。让我们来看看这在不同情境下的含义:
• 如果您要求 Prism 检验不同处理组之间的参数是否存在差异,则这些模型是嵌套的。 您正在比较两种模型:一种是Prism为某些参数分别确定控制数据,另一种是这些参数在数据集之间共享。第二种情况(共享)比第一种情况(单独参数)更为简单(参数较少)。
• 如果您要求 Prism 检验某个参数值是否与假设值不同,那么这两个模型就是嵌套的。 您正在比较两种模型的拟合效果:一种是将参数固定为某个假设值,另一种是让 Prism 为该参数寻找控制数据。第一种情况(固定值)比第二种情况更简单(需要拟合的参数更少)。
•如果您正在比较您选择的两个方程的拟合情况,且两个模型的参数数量相同,则这两个模型不能是嵌套的。在嵌套模型中,一个模型的参数数量少于另一个。 当两个模型的参数数量相同时,Prism 会报告无法计算 F 检验,因为这两个模型的自由度相同。在这种情况下,Prism 不会报告 P 值,而是选择绘制拟合平方和较小的模型。 Prism 会显示错误信息:“模型具有相同的自由度(DF)。”
•如果您正在比较两个参数数量不同的方程的拟合结果,这些模型可能属于嵌套模型,也可能不属于。Prism 不会尝试进行必要的代数运算来确定这一点。 如果您选择的两个模型不具有嵌套关系,Prism 将报告额外平方和F检验的结果,但这些结果将没有实际意义。
P 值的解读
额外平方和F检验基于传统的统计假设检验。F检验将复杂模型带来的平方和(SS)改善程度,与自由度的损失进行比较。
零假设是简单模型(即参数较少的模型)是正确的。复杂模型带来的改进量通过平方和的差异来量化。 仅凭随机性,您就会预期到一定的改善,而这种随机改善的程度由每个模型的自由度数决定。平方和F检验将平方和的差异与随机情况下预期的差异进行比较。结果以F比值表示,并据此计算出P值。
P值回答了以下问题:
如果零假设确实成立,在多少比例的实验(规模与您所做的实验相当)中,平方和的差异会与您观察到的同样大,甚至更大?
如果 P 值较小,则可得出结论:简单模型(零假设)是错误的,并接受复杂模型。通常,P 值的阈值设定为传统的 0.05。
如果 P 值较高,则可得出结论:数据并未提供令人信服的理由来拒绝简单模型。
Prism 会标注零假设和备择假设,并报告 P 值。您可以在非线性回归对话框的“比较”选项卡中设置阈值 P 值。 如果 P 值小于该阈值,Prism 将选择(并绘制)备择(复杂)模型。它还会报告 F 值和自由度,但这些信息仅在您需要将 Prism 的结果与其他程序或手动计算结果进行比较时才有用。
Prism 在比较模型时不报告 P 值的情况
在以下情况下,Prism 会跳过额外的平方和检验,且不报告 P 值:
•如果简单模型对数据的拟合优于(或等同于)复杂模型。F检验的全部意义在于处理这种权衡关系。参数更多的模型对数据的拟合效果更好,但这可能仅仅是偶然现象。 F 检验旨在判断这种拟合度的提升(平方和的减少)是否足够大,以“值得”牺牲自由度(即增加参数数量)。 在极少数情况下,如果简单模型拟合效果优于(或与)复杂模型(即参数较多的模型)相当,Prism 将直接选择简单模型,而无需进行 F 检验,并报告“简单模型拟合效果更好”:
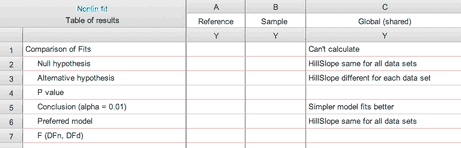
• 如果任一模型的拟合结果存在模糊拟合或被标记,则 Prism 会直接选择另一个模型,而不会进行任何统计检验。您可以在非线性回归的“比较”选项卡中选择关闭此标准。
•如果其中一个模型的拟合未收敛,则 Prism 会选择另一个模型,且不进行 F 检验。由于其中一个模型的拟合未收敛,比较两个模型的平方和便没有意义。
•如果其中一个模型与数据完美拟合,则其平方和等于零。如果其中一个模型完美拟合,Prism 会直接选择该模型,而不会进行平方和F检验。
•如果两个模型的自由度相同。平方和F检验的原理是在“平方和的改善(拟合效果更好)”与“自由度的减少(参数更多)”之间取得平衡。 如果两个模型的自由度相同,F检验就没有意义(而且由于除以零在数学上是不可能的)。在这种情况下,Prism会选择拟合优度最好的模型。
