如果将“加权”选项卡中的选项保留为默认设置——即不进行加权——而散点实际上与Y值有关,会发生什么情况?当然,答案是“视情况而定”。这取决于散点的大小,以及Y值的范围有多大。 本文剩余部分将通过本示例,并模拟多个数据集,来探讨当拟合操作不当的情况下会发生什么。
模拟
我选择了一个非常简单的模型——一条直线。我模拟的数据使得沿直线任意一点的离散度标准差与该点的Y值成正比。下图展示了一组模拟数据集。您可以清楚地看到,随着直线向上延伸,重复测量结果之间的离散度逐渐增大。
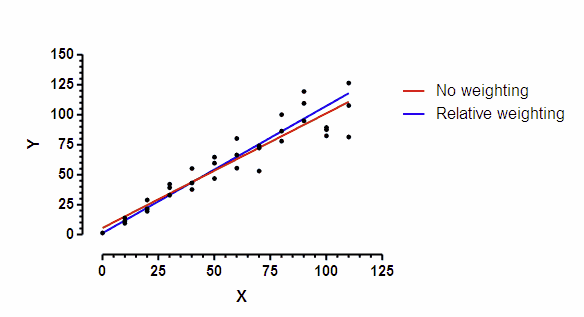
该直线是通过“非线性”回归拟合得到的。Prism 的线性回归分析不提供差异加权功能,但“非线性”回归可以在拟合直线时使用线性回归分析中不具备的多种选项。
红色曲线采用默认设置——不加权;最小化残差平方和。蓝色曲线采用相对权重。当您预期重复测定残差的标准差与Y值成正比时,此选项较为合适。这两条曲线并不完全相同。
我使用 Prism 的蒙特卡洛分析模拟了 5000 个此类数据集。对这 5000 个模拟数据集中的每一个,我都分别进行了无加权和具有相对权重的(即相对加权)回归拟合。 对于这5000个数据集中的每一个,我都记录了两种分析方法所得的控制数据及其标准误差(SE)。
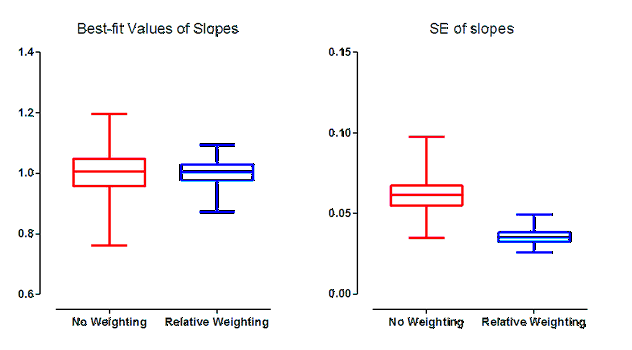
重复实验之间的离散程度与Y成正比,因此相对权重是合适的。这些模拟结果以蓝色显示。红色结果则显示了采用等权重(默认设置)进行回归分析时的结果。 盒须图的范围从第25百分位数延伸至第75百分位数,中位线(第50百分位数)位于盒须图中央。盒须图两端的须线分别延伸至最小值和最大值。
上图左侧展示了斜率控制数据的分布情况。 选择错误的加权方案并不会系统性地导致最佳拟合斜率值过高(过陡)或过低(过缓)。事实上,在无加权和相对权重拟合中,斜率的最佳拟合中位数值几乎完全相同。 但请注意,未采用加权处理的结果其斜率分布范围要宽得多。由于这些是模拟数据,我们知道真实斜率(1.0),因此可以量化每个数据集的最佳拟合斜率与该理想值的偏差。 在不采用差异加权的情况下(红色),数据拟合的误差中位数为 0.04610,而采用相对权重(蓝色)的模拟结果中,该误差中位数为 0.02689。在本示例中,选择错误的加权方案导致误差中位数增加了 71%。
上图右侧展示了斜率标准误差的分布情况。当对所有数据点采用等权重拟合时,斜率的标准误差平均值明显更高,且一致性更差(离散度更大)。 未加权拟合的标准误中位数比加权拟合的标准误中位数高出73%。由于置信区间的宽度与标准误成正比,这意味着在未加权拟合的情况下,置信区间的中位数宽度扩大了73%。
由于这些是模拟数据,我们知道真实的总体斜率(即1.0)。因此,我们可以针对每次模拟检查所报告的95%置信区间是否包含真实值。 在采用相对权重模拟的情况下,95.3%的模拟数据集所得到的95%置信区间包含了真实值。而当对同一组数据集进行无权重分析时,仅有92.6%的“95%”置信区间包含了真实值。
总结
综上所述,当我们在本示例中选择了错误的加权方案时:
•斜率的控制数据精度较低。
•斜率的标准误更大,因此置信区间更宽。
•尽管95%置信区间更宽,但仍不够宽。“95%”置信区间在不到95%的模拟中包含了真实值。
本示例只是一个例子。在其他例子中,加权方法的选择可能影响较小。但在另一些例子中,其影响可能更大。因此,尝试选择合适的加权方案是值得的。
