1. 创建列表
在“欢迎”或“新建表”对话框中,选择“列”选项卡。
2. 输入 P 值
将已在其他地方计算好的 P 值输入到 A 列中。
每个值必须是 P 值(介于 0.0 和 1.0 之间)。不能输入“<0.0001”、“ns”或“**”。您输入的每个 P 值必须是小数。
可选:在每个 P 值旁边输入列标题,以标识相应的比较。这将有助于理解结果。如果您未输入行标题,Prism 将使用原始行号来标注结果。
此分析通常用于处理数百或数千个P值,但也可用于任意数量的P值。
3. 选择分析方法
单击“分析”(Analyze),在“列分析”(Column analyses)列表中查找并选择“分析一组 P 值”(Analyze a stack of P values)。
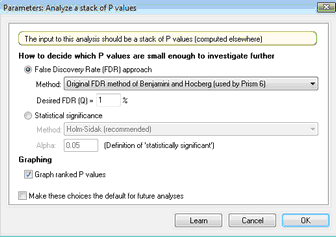
从两种通用方法中选择一种:控制错误发现率(FDR)或控制该比较族的第一类错误率。然后选择希望 Prism 采用的具体方法。
控制错误发现率(FDR)
从三种方法中选择一种,以确定哪些 P 值足够小,可被标记为“发现”。 我们推荐 Benjamini、Krieger 和 Yekutieli 的自适应方法 (1),因为其功效更强。Benjamini 和 Hochberg 的原始 FDR 方法 (2) 虽更为人熟知,但功效较弱。Benjamini 和 Yekutieli 的方法假设较少,但功效也明显较弱。
还需设置 Q 的值,其目标是确保被标记为“发现”的比较中,虚假发现(假阳性)的比例不超过 Q%。请输入百分比,而非分数。 若希望发现中虚假发现的比例不超过 5%,请输入“5”,而非“0.05”或“5%”。实际上并没有标准值。若输入较大的数值,会被标记为发现的比较会更多,但其中虚假发现的比例也会相应增加。
统计学显著性(控制比较族的第一类错误率)
选择 Prism 用于校正多重比较的方法。我们建议使用 Holm-Šídák 方法,该方法具有最高的功效。其他可选方法包括 Bonferroni-Dunn 法或 Bonferroni-Šídák 法。 我们称为“Bonferroni-Dunn”的方法通常简称为“Bonferroni”。我们称为“Bonferroni-Šídák”的方法通常简称为“Šídák”。这两种方法非常相似。Bonferroni-Šídák方法的功效略高,但人们对其了解较少。
设置适用于整个 P 值族(family)的 α 值。Prism 随后将根据该 α 值,在进行多重比较校正后,判定哪些 P 值足够小,从而使相关比较被认定为“统计学显著”。请输入分数,而非百分比。 如果您希望在零假设下,有 5% 的比较被错误地标记为“显著”,请输入 0.05 而不是 5。如果您输入更大的数值,会有更多比较被标记为“显著”,但其中更多将是假阳性。 对于统计学显著性,在进行一次或几次比较时,α通常设置为0.05。但在进行大量比较时,您可能需要输入一个更高的值。
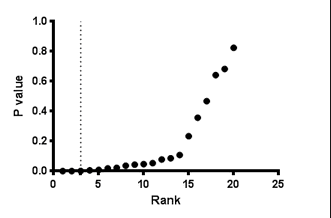
绘图
若需查看 P 值秩与 P 值的关系图,请勾选此选项。这是可视化 P 值分布的常用方法。
参考文献
1.Benjamini, Y., Krieger, A. M. & Yekutieli, D. 控制错误发现率的自适应线性递增法。《生物计量学》93, 491–507 (2006)。
2.Benjamini, Y. & Hochberg, Y. 《控制错误发现率:一种实用且具有强大功效的多重检验方法》。《皇家统计学会期刊》B辑(方法论)289–300 (1995)。
3.Benjamini, Y. 与 Yekutieli, D. (2001). 存在依赖度时多重检验中错误发现率的控制。《统计年鉴》,1165–1188。
