本指南将引导您逐步完成使用 Prism 进行简单逻辑回归的流程。逻辑回归功能自 Prism 8.3.0 版本起已加入
数据
首先,我们需要在“欢迎”对话框中创建一个新的XY数据表
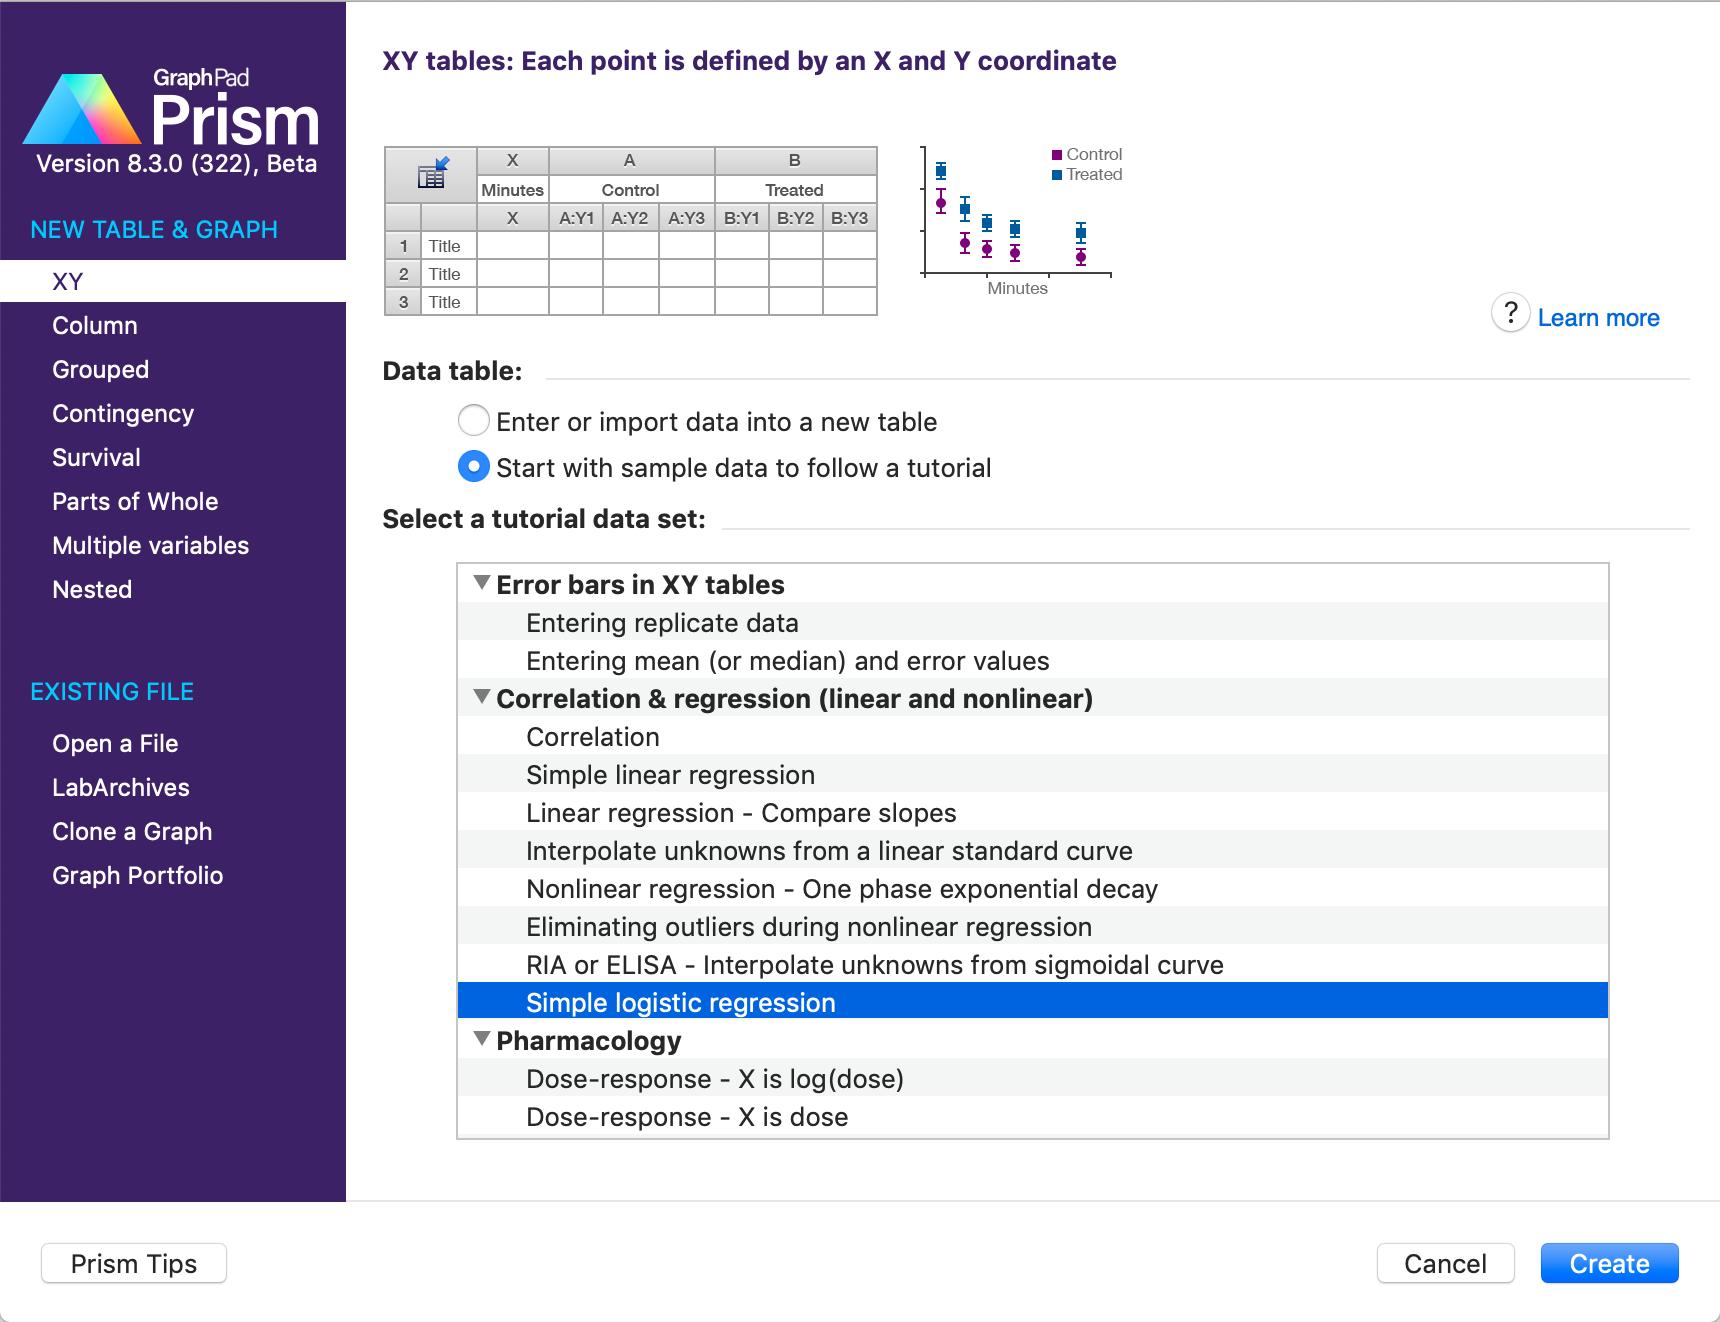
为了便于本教程演示,我们将使用示例文件中“相关与回归”部分提供的“简单逻辑回归”示例数据。要使用该数据,请在列表中点击“简单逻辑回归”,然后点击“创建”。 随后将显示一组包含两列的数据:X列为“学习时长”,Y列为“考试通过?”。
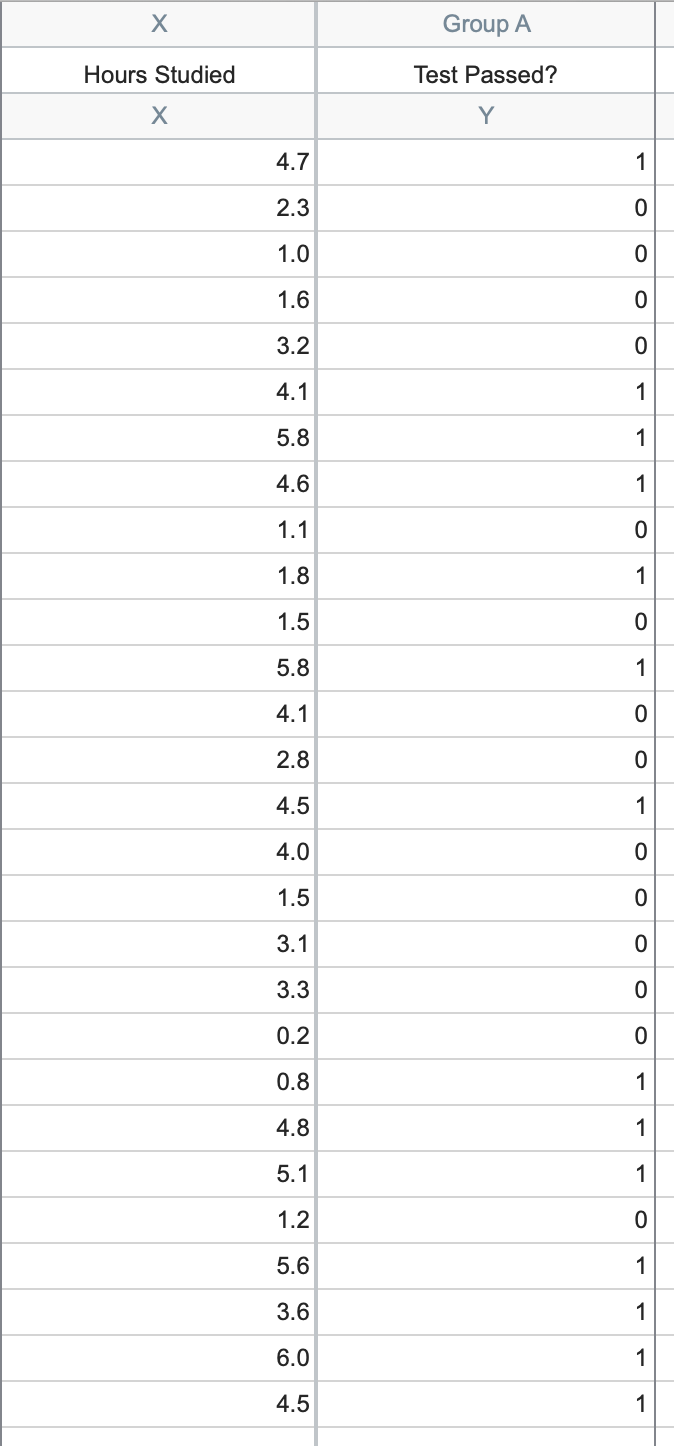
该数据记录了125名学生为备考所花费的时间及其考试结果:学生是否通过考试(在数据表中输入为1),还是未通过考试(在数据表中输入为0)?
开始分析
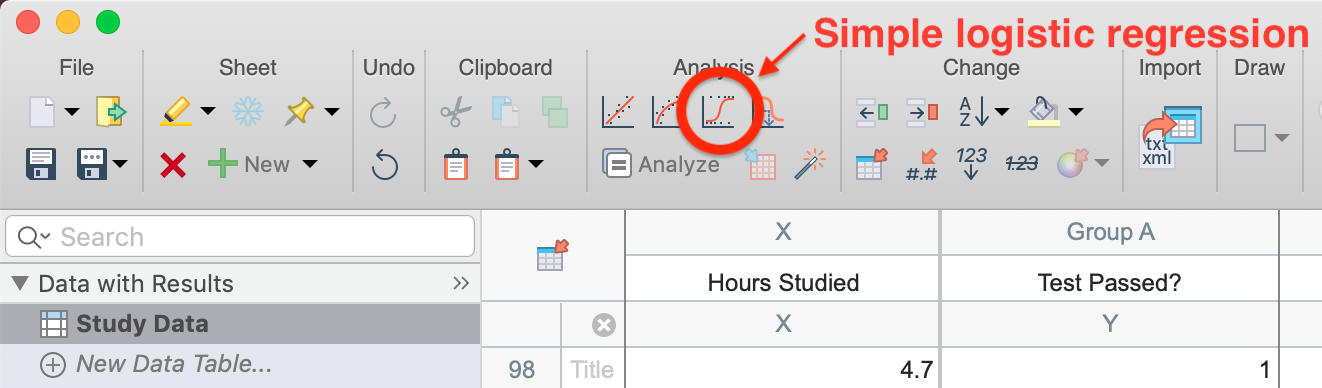
要对该数据集进行简单逻辑回归分析,请点击工具栏中的“简单逻辑回归”按钮(如下图所示)。或者,您也可以点击工具栏中的“分析”按钮,然后从可用的XY分析列表中选择“简单逻辑回归”。
分析对话框
点击“简单逻辑回归”按钮后,将显示该分析的参数对话框。在本操作指南中,我们无需更改任何默认选项。下文将讨论其中部分选项的设置效果,有关这些选项的更多信息可参见此处。
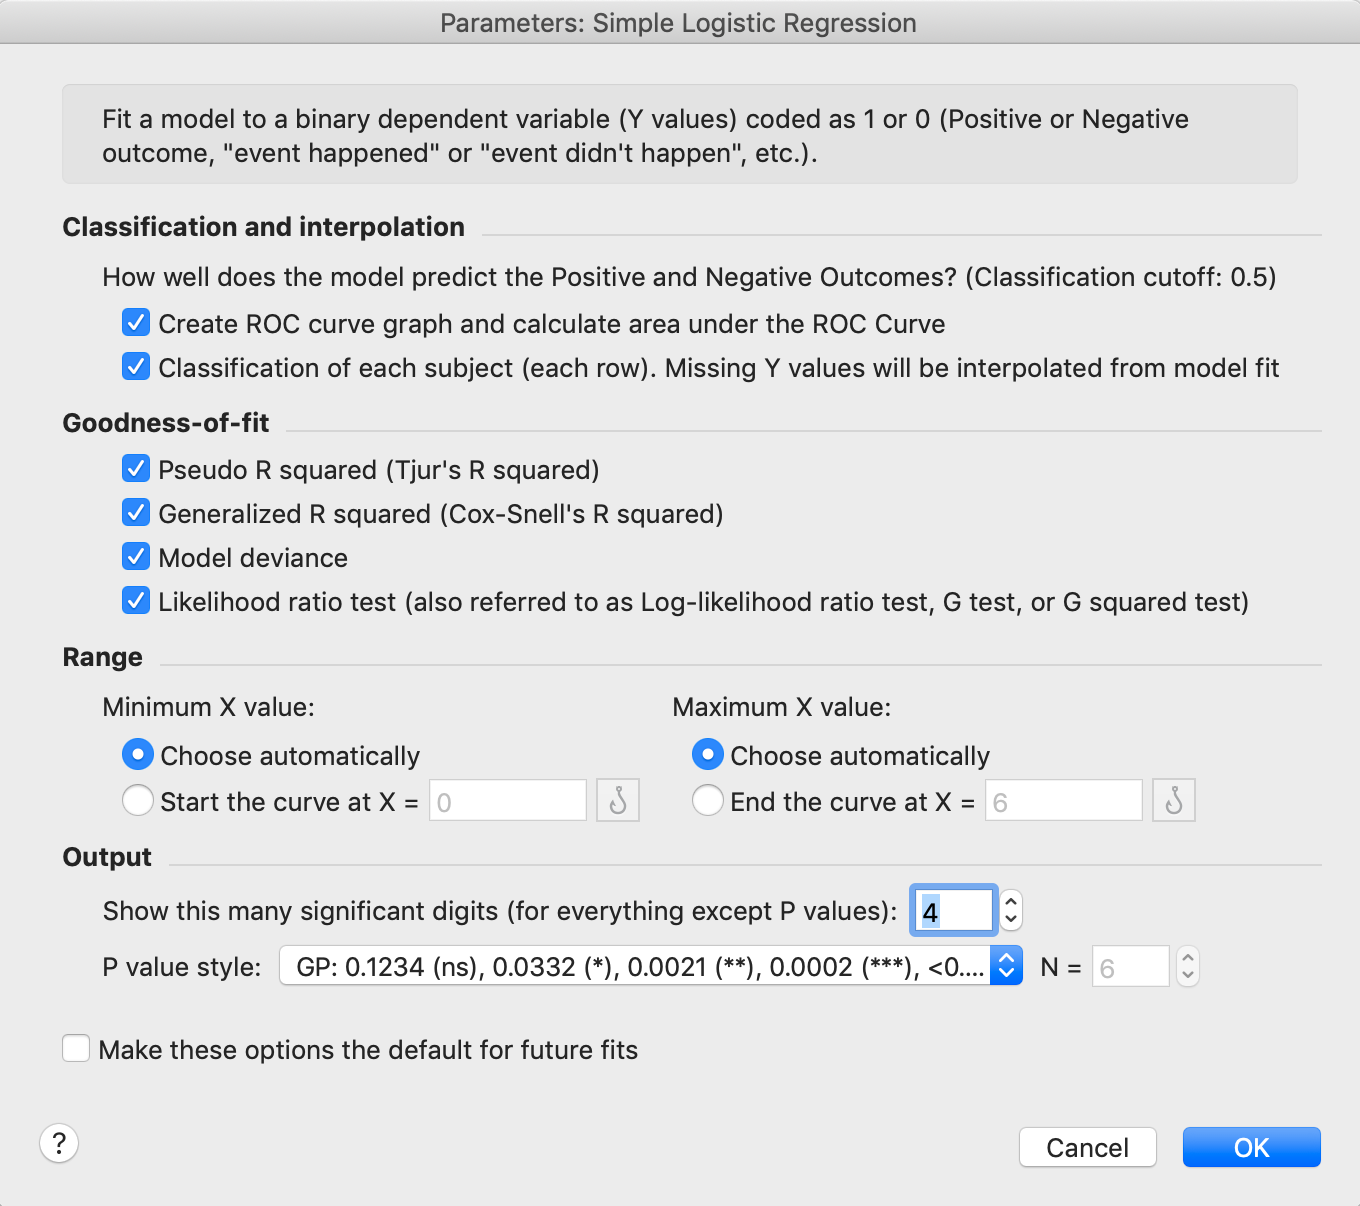
点击“确定”后,系统将跳转至主结果表,相关内容将在下一节中进行说明。
简单逻辑回归的结果
参数估计值
在结果表中,您首先会看到 β0 和 β1 的控制数据,以及相应的标准误差和 95% 置信区间。
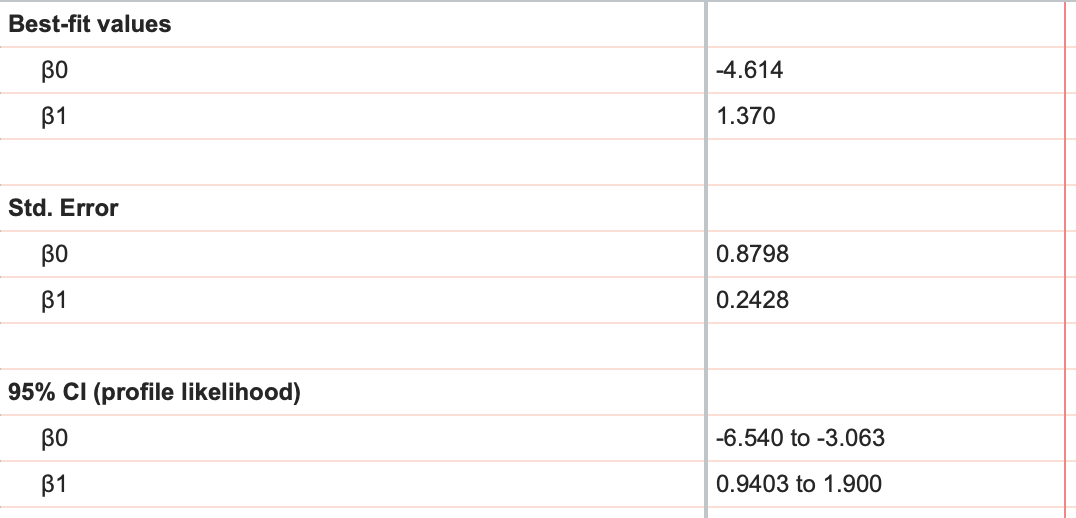
根据这些参数与“对数几率”的关系,它们有时分别被称为“截距”和“斜率”。
优势比
由于很难直接解读 β0 和 β1,因此通常会参考优势比及其 95% 置信区间(在结果表的下方列出)。
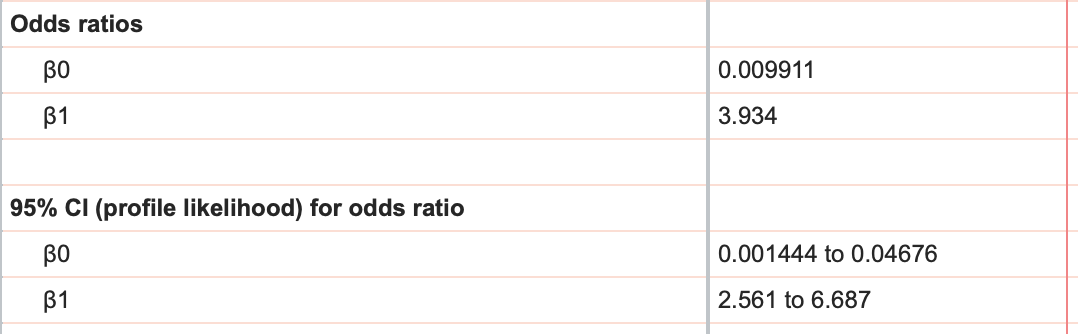
关于优势比的更详细解释可参见此处,但 β1 的优势比告诉我们的是:X 每增加 1,成功的几率就会乘以 β1 的值。以这些结果中的数值为例。 回顾一下,X 代表学习时长。因此,优势比为 3.934 意味着:每多学习 1 小时,通过考试的几率就会增加近 4 倍!
如果您尚未了解概率与几率之间的关系,以下是一个简要总结:
几率 = 成功概率 / 失败概率
由于失败概率就是 1 - 成功概率,我们可以将其表示为:
几率 = (成功概率) / (1 - 成功概率)
例如,假设成功概率为75%,则几率可计算为:
几率 = 0.75/(1 - 0.75) = 0.75/0.25 = 3
通常,我们会说“几率是3:1”(读作“三比一”)。
X 对应 50%
Prism 在简单逻辑回归中报告的另一个关键值是:当成功概率被预测为 50%(或 0.5)时,X 的数值。 有趣的是,利用上述几率计算公式,我们可以发现当概率为50%时,几率等于1(也称为“平赔”)。 在本例中,50% 时的 X 值为 3.37,这意味着对于那些学习了 3.37 小时的学生来说,通过考试的几率为 1:1(通过概率为 50%……并不理想!)。
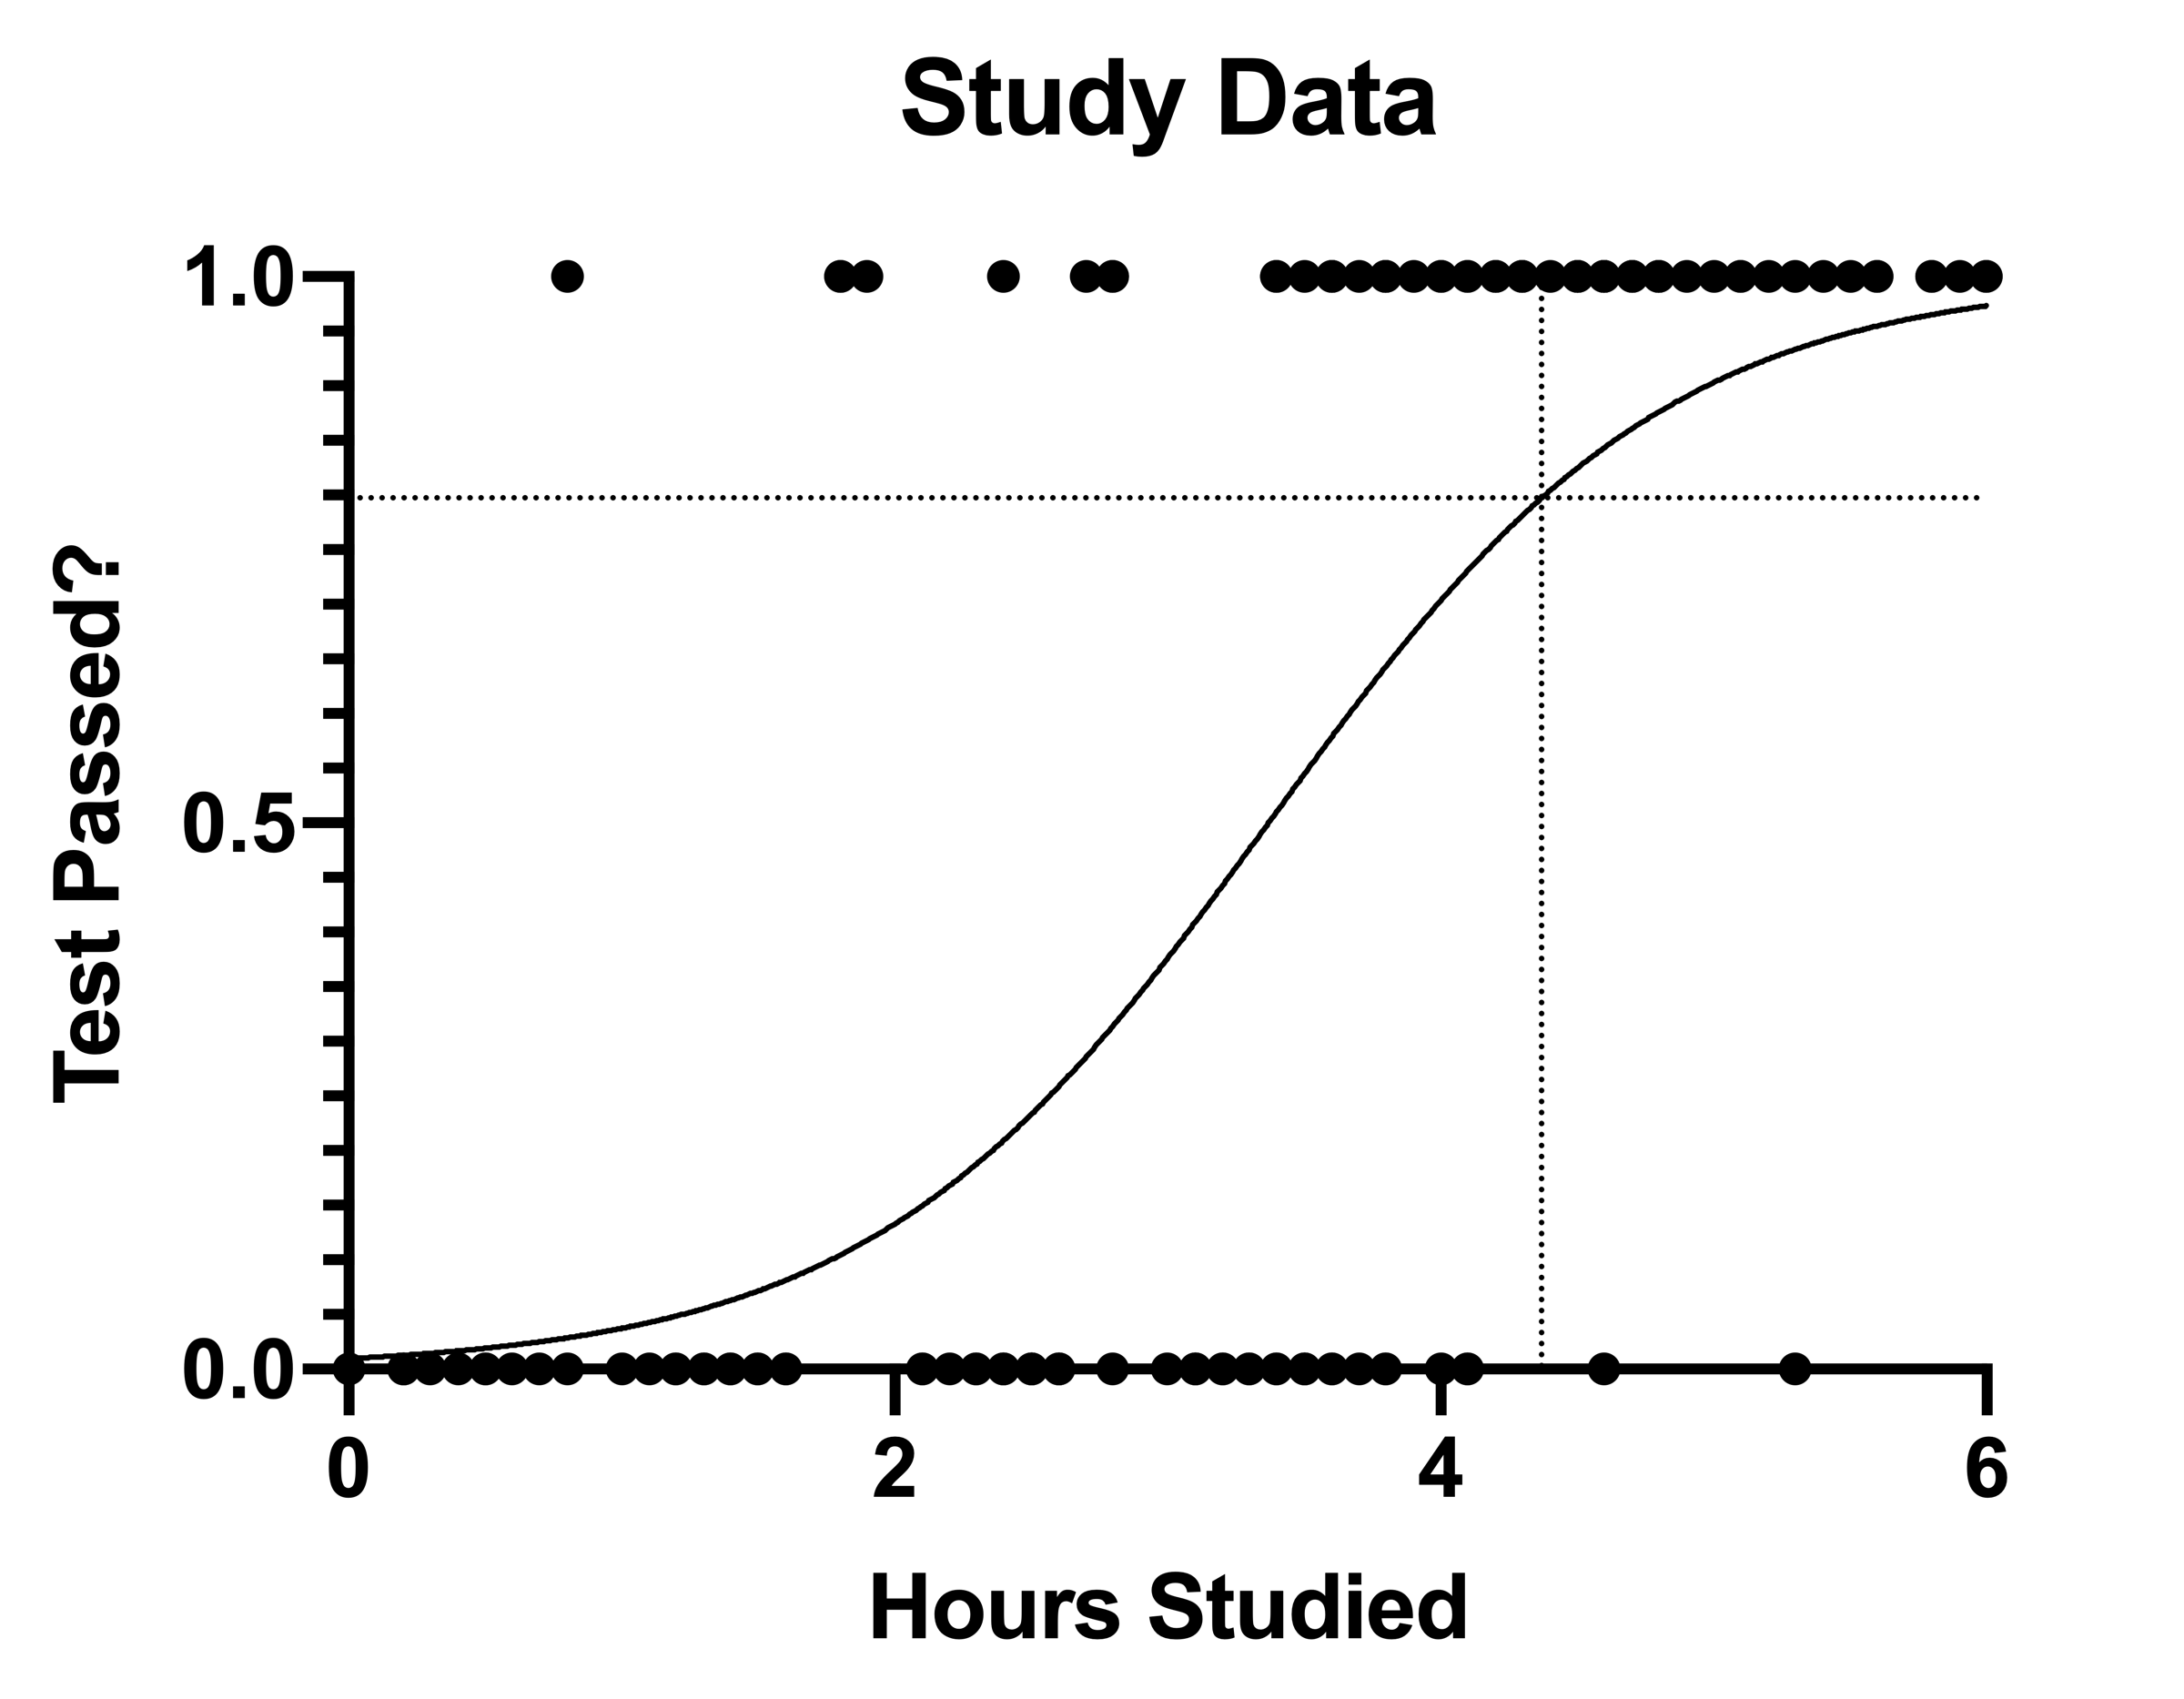
如果我们将这一结果与优势比结合起来,就可以快速确定学生多学习一小时时的通过几率和赔率。 请记住,Prism报告的优势比告诉我们,当X增加1时,优势比会增加多少倍。我们知道,当X为3.37时,优势比为1,而优势比为3.934。 因此,当X增加1(从3.37增至4.37)时,新的几率即为1×3.934,即3.934。这就是学习4.37小时(仅多学1小时)的学生预计的通过几率。
将该几率转换为概率很简单:
几率 = 3.934 = (成功概率)/(1 - 成功概率)
3.934 × (1 - 成功概率) = 成功概率
3.934 - 3.934*(成功概率) = 成功概率
3.934 = 成功概率 + 3.934*(成功概率)
3.934 = (成功概率) * (1 + 3.934)
3.934 = (成功概率) × 4.934
成功概率 = 3.934/4.934
成功概率 = 0.797 或 79.7%
逻辑回归曲线
如果我们暂时抛开结果表,可以看看逻辑回归根据我们的数据绘制的曲线。下图证实了我们在前几节中得出的部分观察结果:
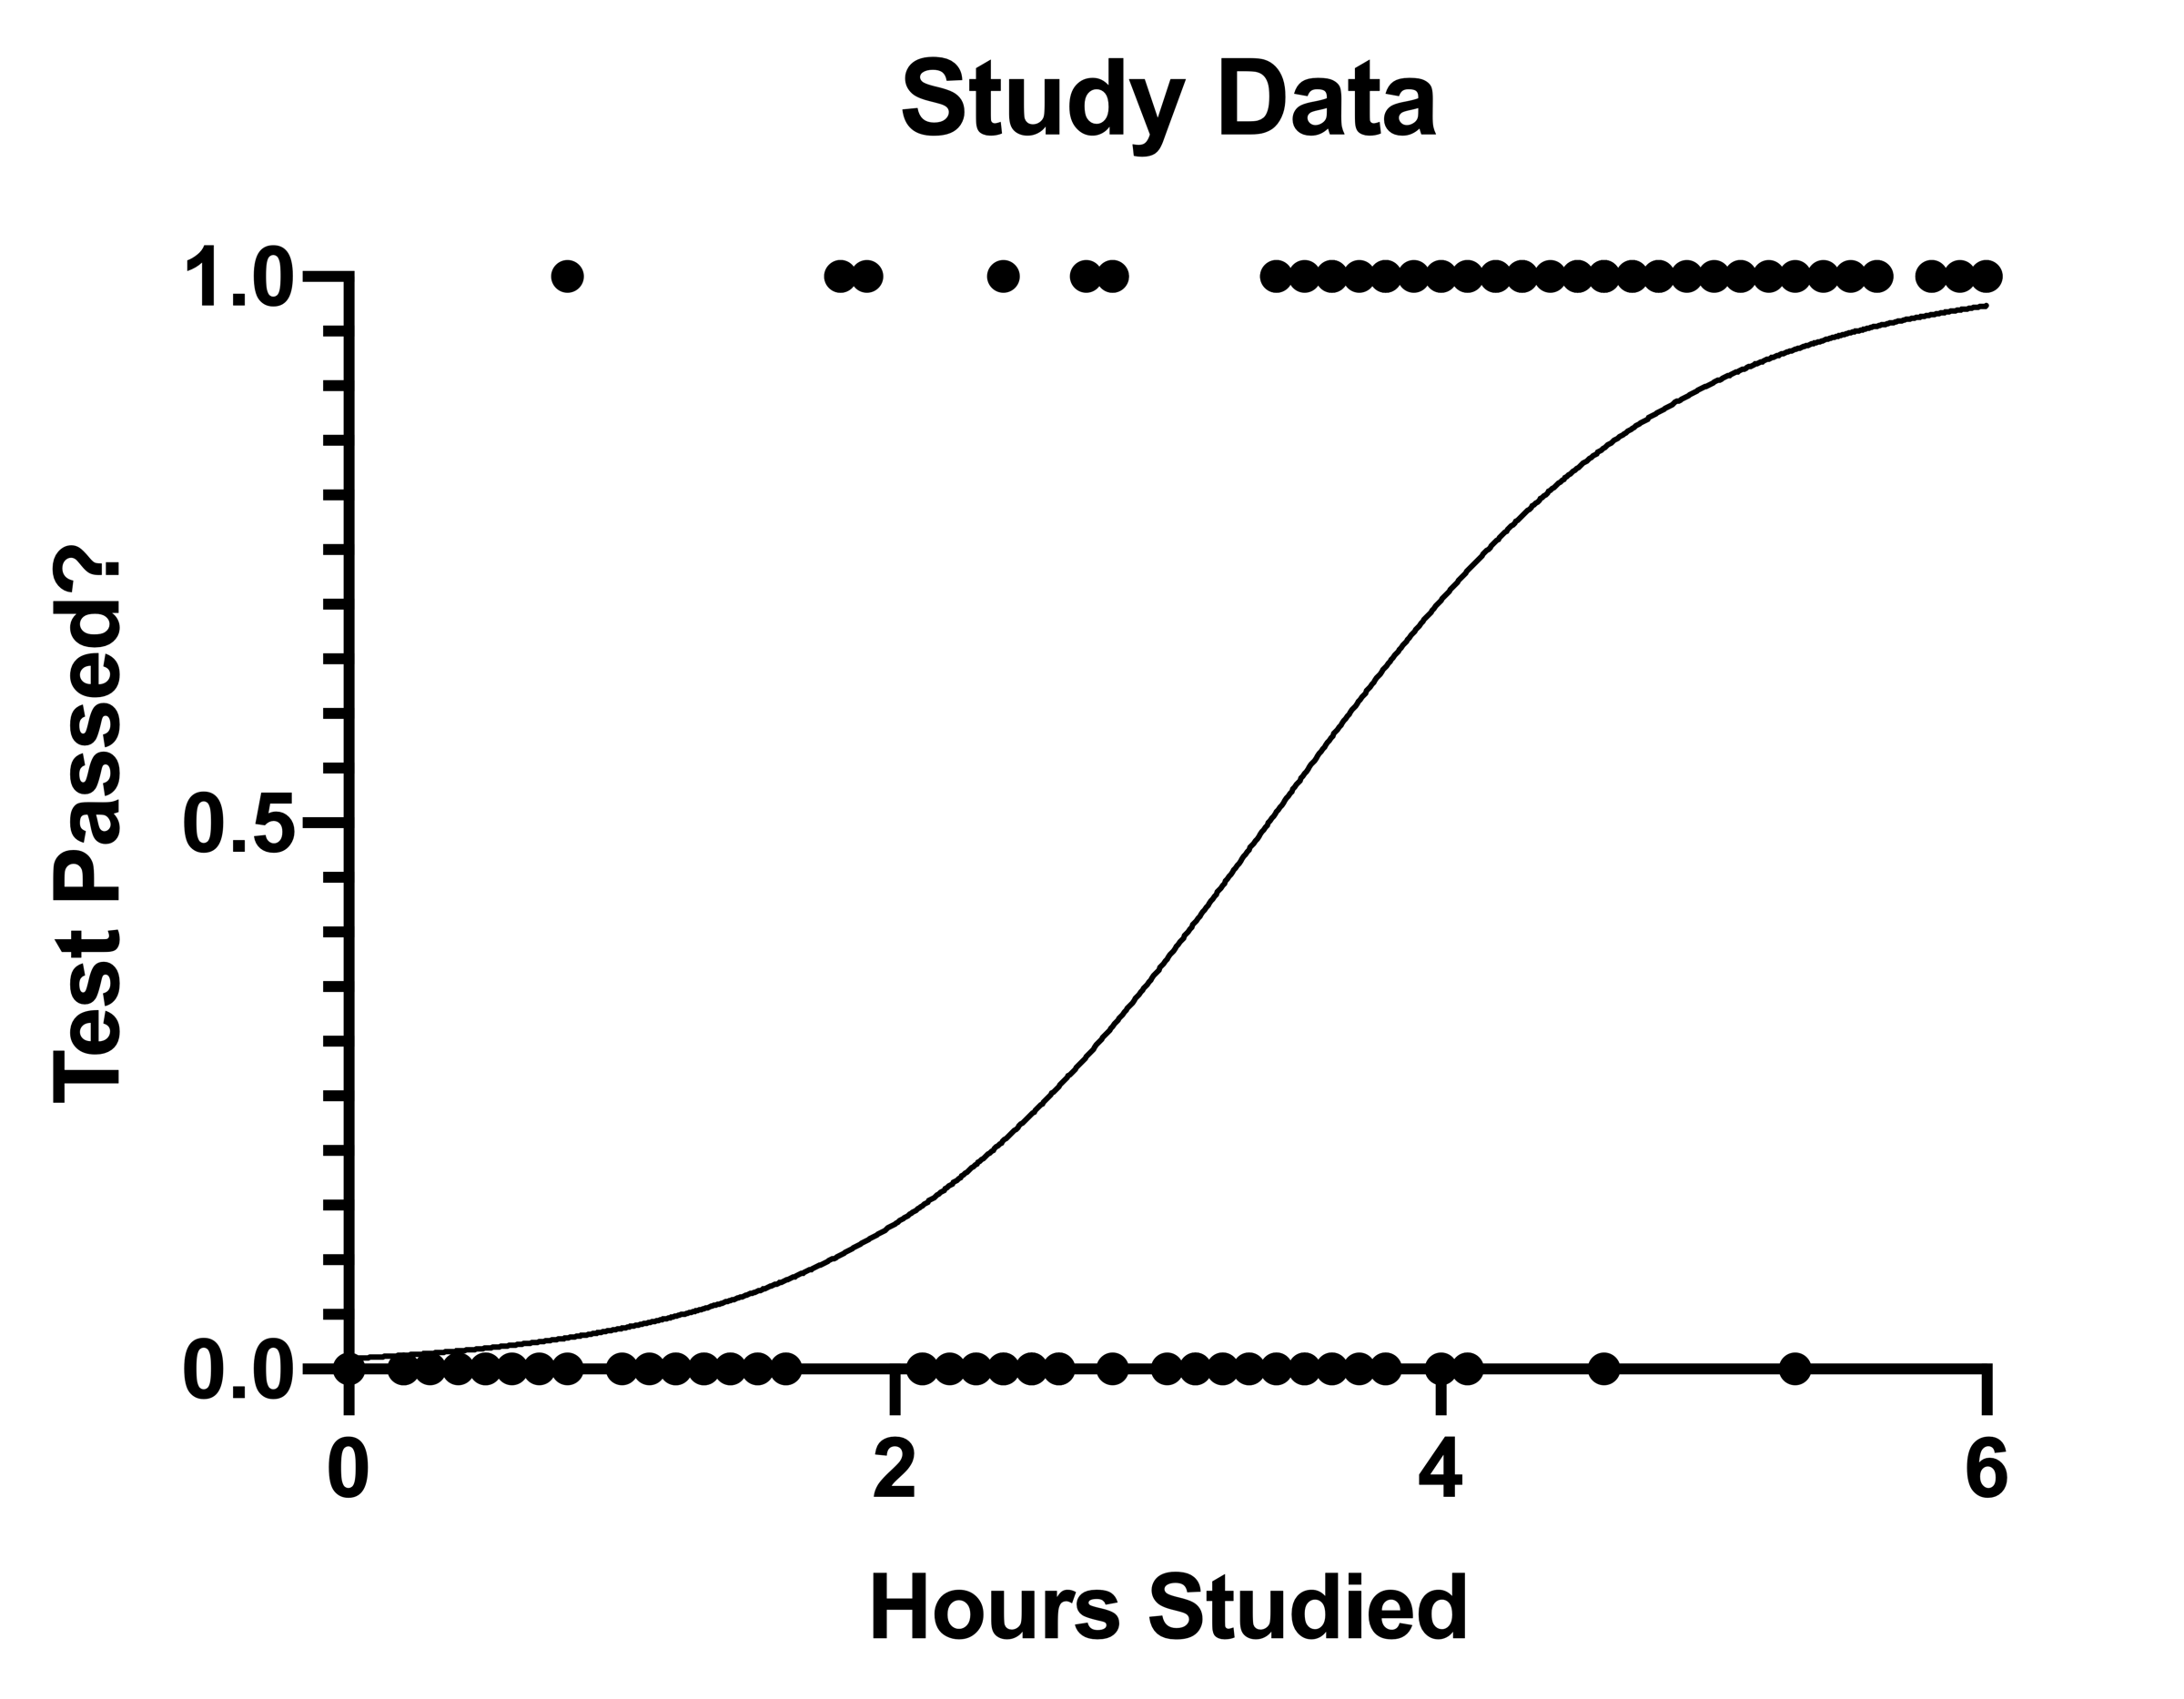
该图中的曲线描绘了通过考试的预测概率(Y)与学习时长(X)的关系。正如我们所讨论的,我们可以迅速发现:当学习时长为 3.37 小时时,通过考试的预测概率为 50%:
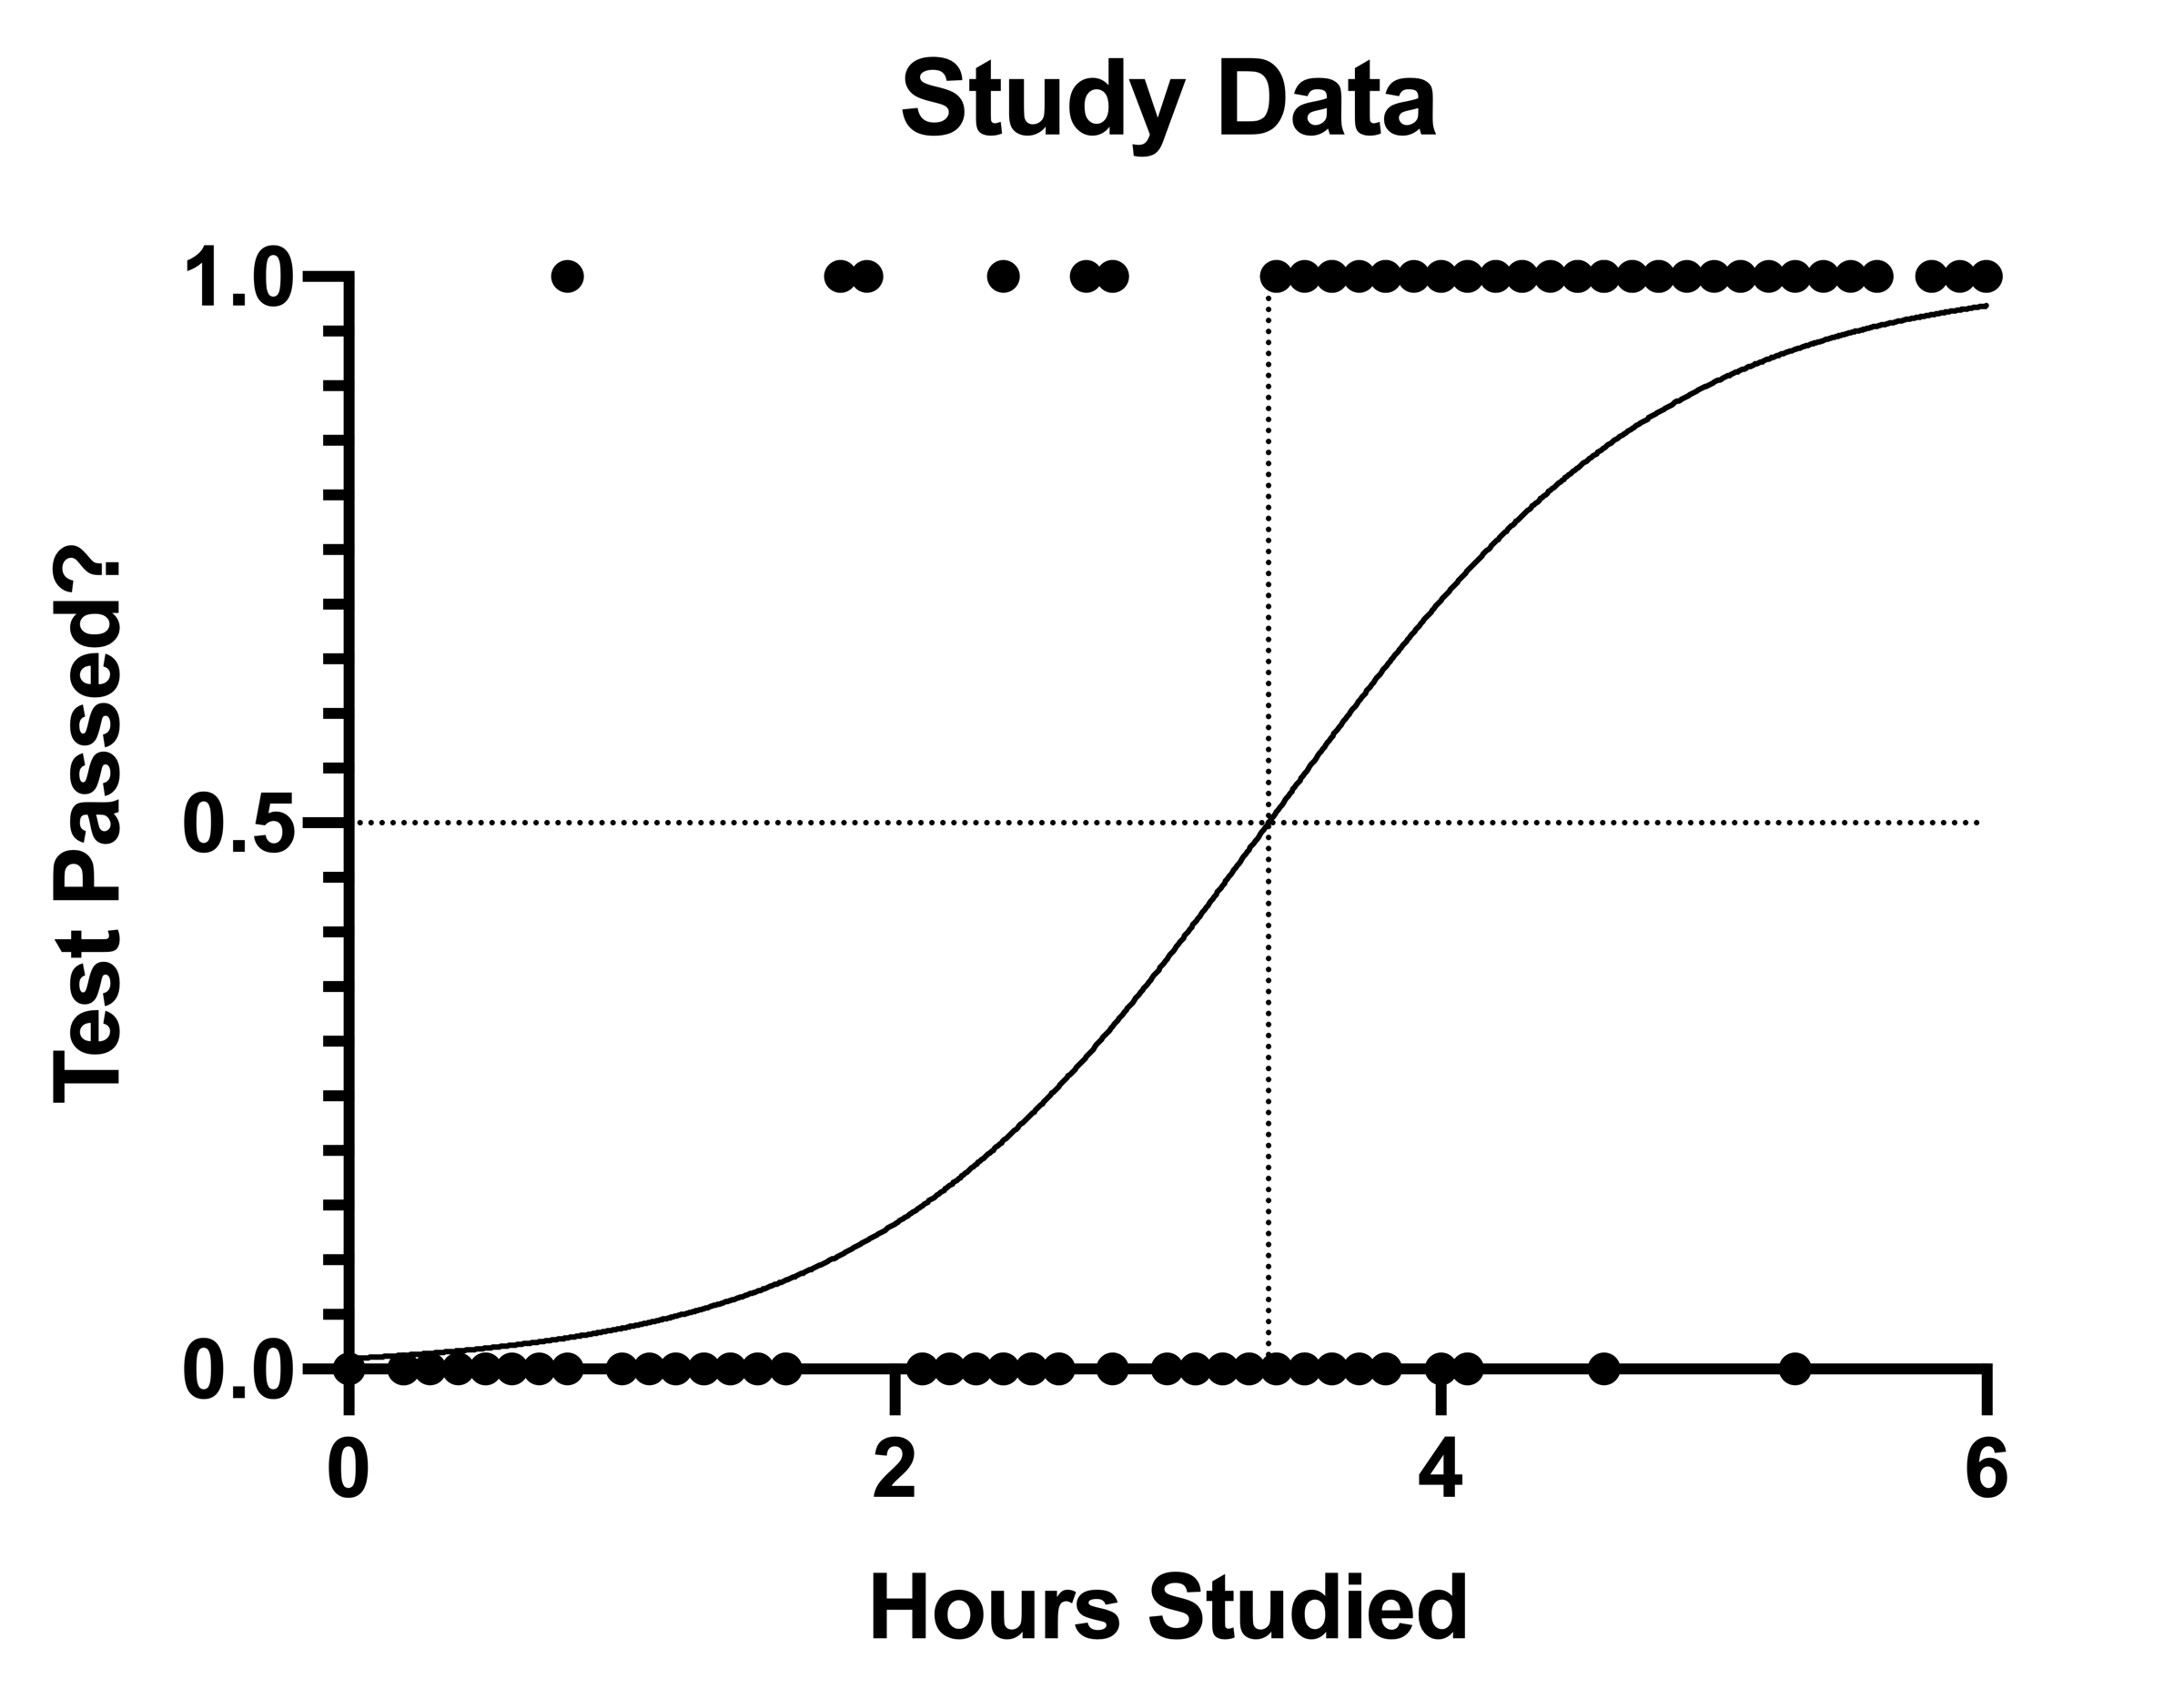
我们还可以通过这张图表验证关于优势比的论点。我们可以看到,当学习时间增加一小时(总计达到 4.37 小时)时,通过考试的预测概率会升至约 80%:
实际上,您可以利用这条曲线来确定任意给定学习时间下的考试通过预测概率。下一节将讨论如何根据输入的任意X值来确定考试通过的预测概率
行预测
如果我们切换回简单逻辑回归的主结果表,您会看到顶部有一个名为“行预测”的标签页。点击该标签页后,Prism 将提供所有已输入 X 值的预测概率完整列表:
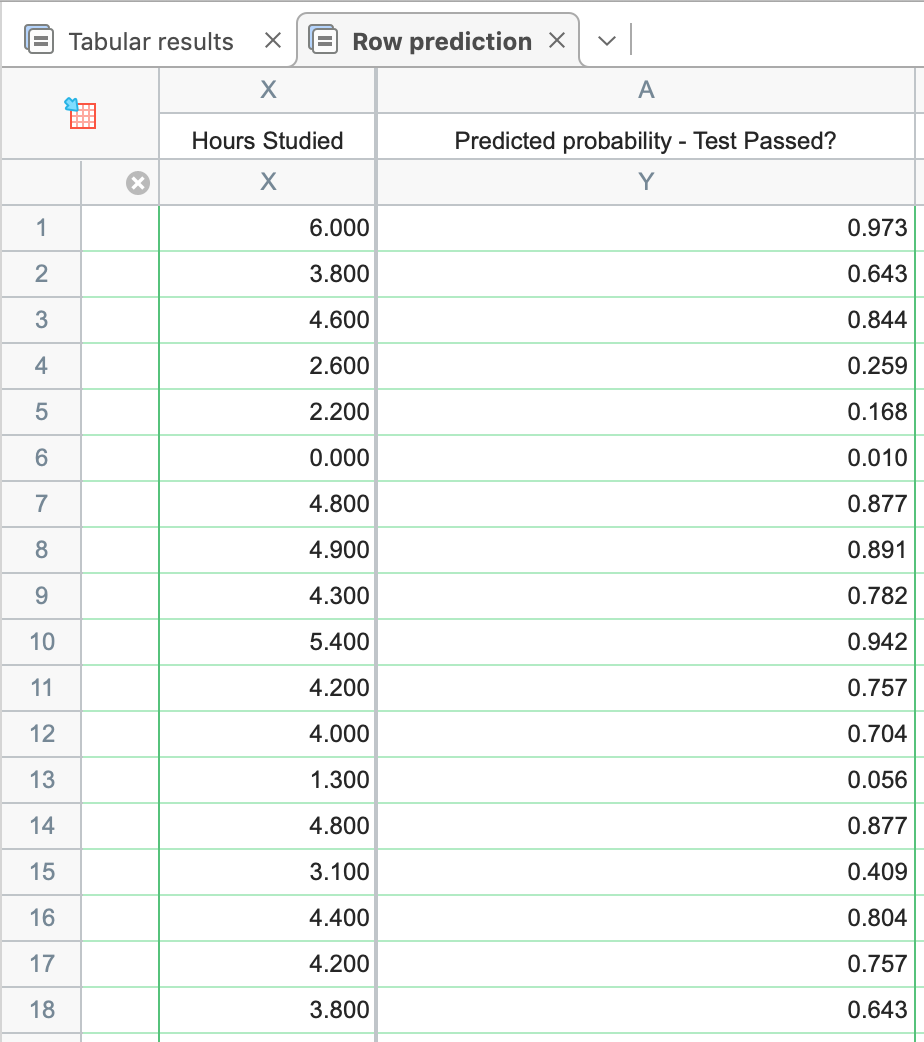
该表格提供了数据表中所有 X 值的预测概率。这既包括数据中已拟合的 X 值,也包括未关联 Y 值而单独输入的 X 值。例如,假设您想知道在该模型下,学习时间为 5.7 小时时的考试通过概率。 在这份数据集中,有 125 名学生,但没有一人学习了 5.7 小时,回到原始数据表后,您可以将 5.7 输入到 X列底部(不关联 Y 值),然后返回“行分类表”:
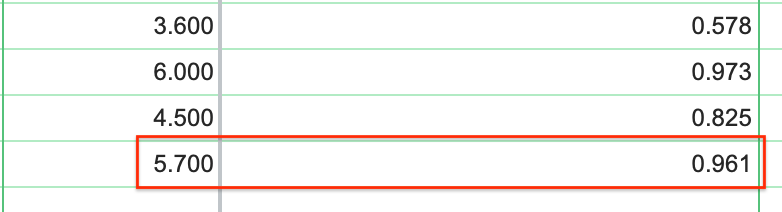
该结果告诉我们——基于对125名学生的观察——如果一名新学生为同一场考试学习5.7小时,其通过的概率将达到96.1%!
假设检验
如果我们点击返回结果表的“表格结果”选项卡,就可以继续探究简单逻辑回归报告的其他结果。 结果的下一部分提供了两种不同的方法来检验模型与数据的拟合程度。虽然这些检验非常相似,但要正确解释结果,理解每种检验的工作原理及其所检验的假设至关重要。
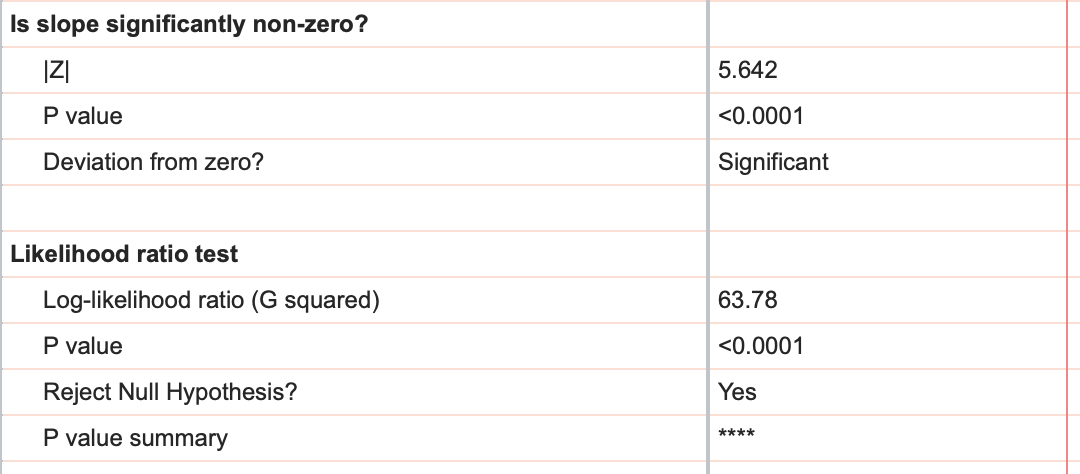
根据本数据集给出的结果,我们可以得出结论:学习(由系数 β1 表示)的影响显然不为零;换言之,学习时间的长短对通过考试的概率确实产生了影响。
ROC曲线与ROC曲线下面积
结果的下一部分专门讨论了所谓的 ROC 曲线。本分析的 ROC 曲线在“导航器”的“图表”部分中提供,如下所示:
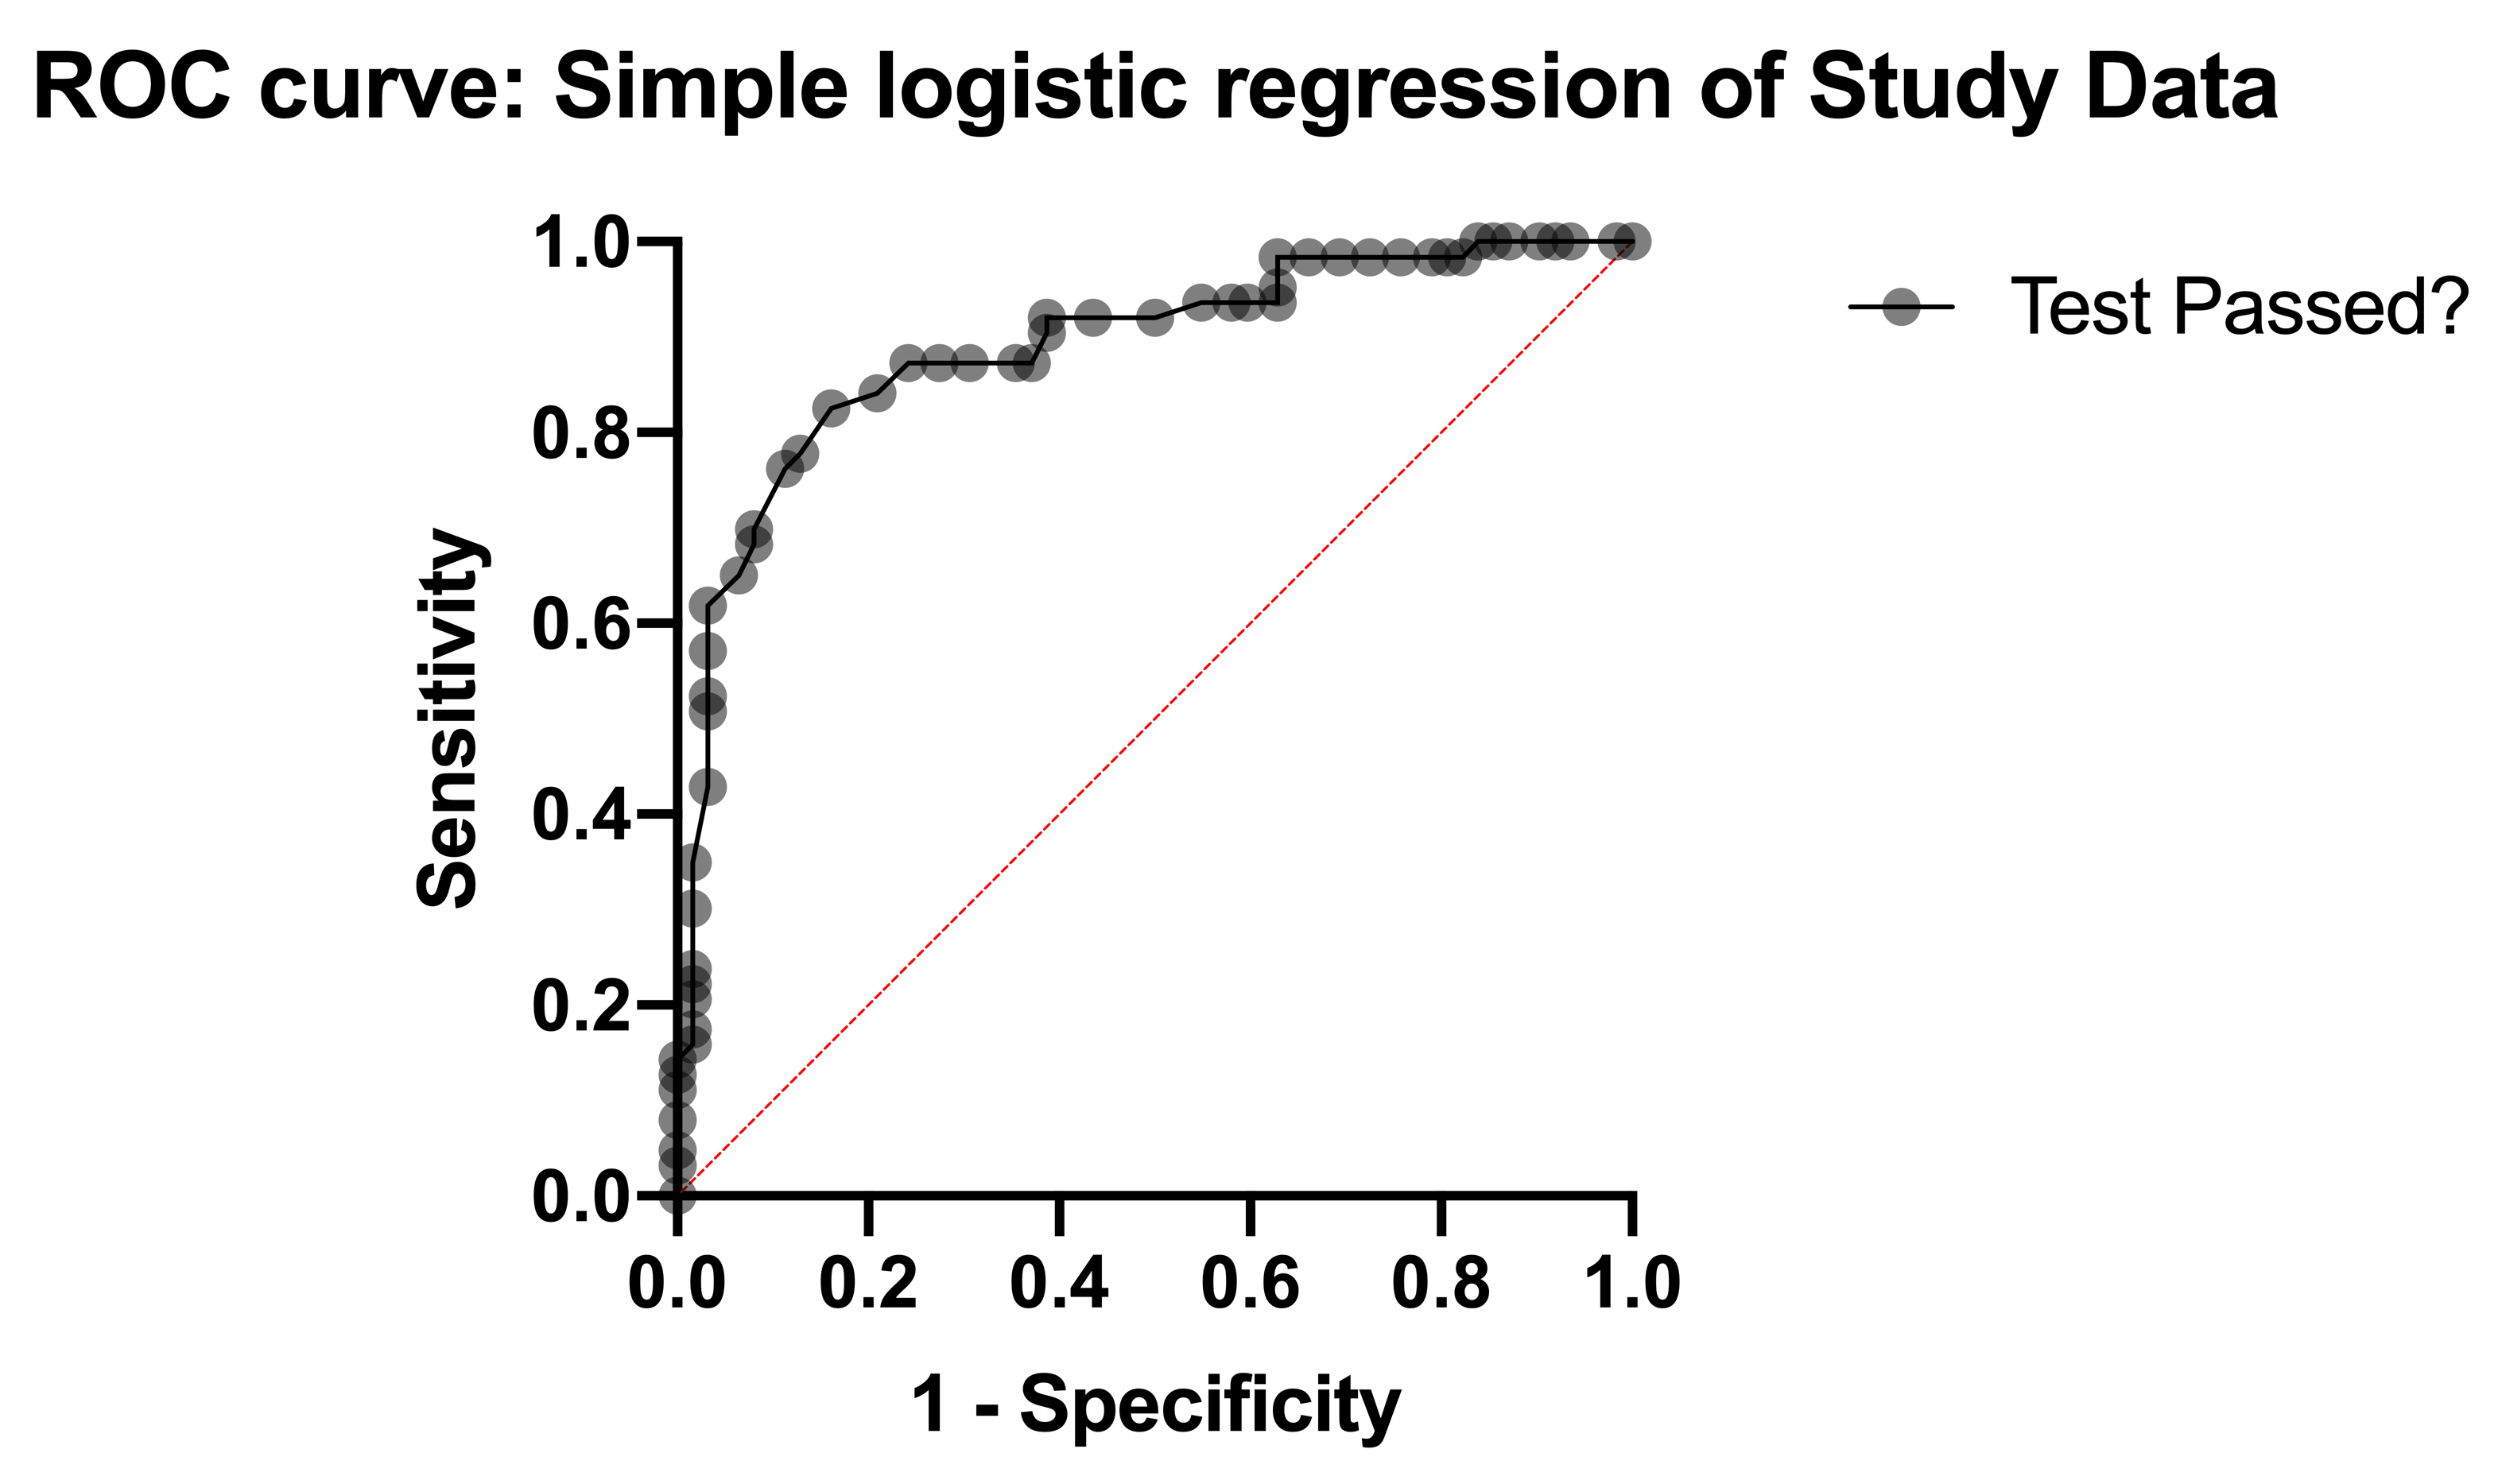
理解 ROC 曲线需要一些经验,但归根结底,这些图表向您展示的是模型正确分类“成功”案例的能力与其正确分类“失败”案例的能力之间的关系。模型通过设定一个阈值来对观察值进行分类。 任何大于该阈值的预测概率均被分类为 1,而任何小于该阈值的预测概率则被分类为 0。若设置极低的阈值,几乎可以肯定会正确分类所有观测到的成功案例。 被正确分类的观测成功案例所占的比例称为“灵敏度”,并绘制在 ROC 曲线的 Y 轴上(Y 值为 1 表示对成功案例的完美分类,而 Y 值为 0 表示对成功案例的完全误分类)。
然而,如果阈值设定得非常低,您也很可能会将许多失败错误地分类为成功。 特异性是指正确分类的失败案例的比例,“1-特异性”被绘制在 X 轴上(因此,X 值为 0 表示对失败案例的完美分类,而 X 值为 1 表示对失败案例的完全误分类)。
可以想象,随着阈值的变化(从 0 到 1),被正确(和错误)分类的观察到的成功与失败之间将存在权衡。 ROC曲线所展示的正是这种权衡关系:随着敏感度增加,特异性必然下降(即“1-特异性”必然上升)。ROC曲线上的每个点代表一个不同的阈值,并对应相应的灵敏度和特异性数值。
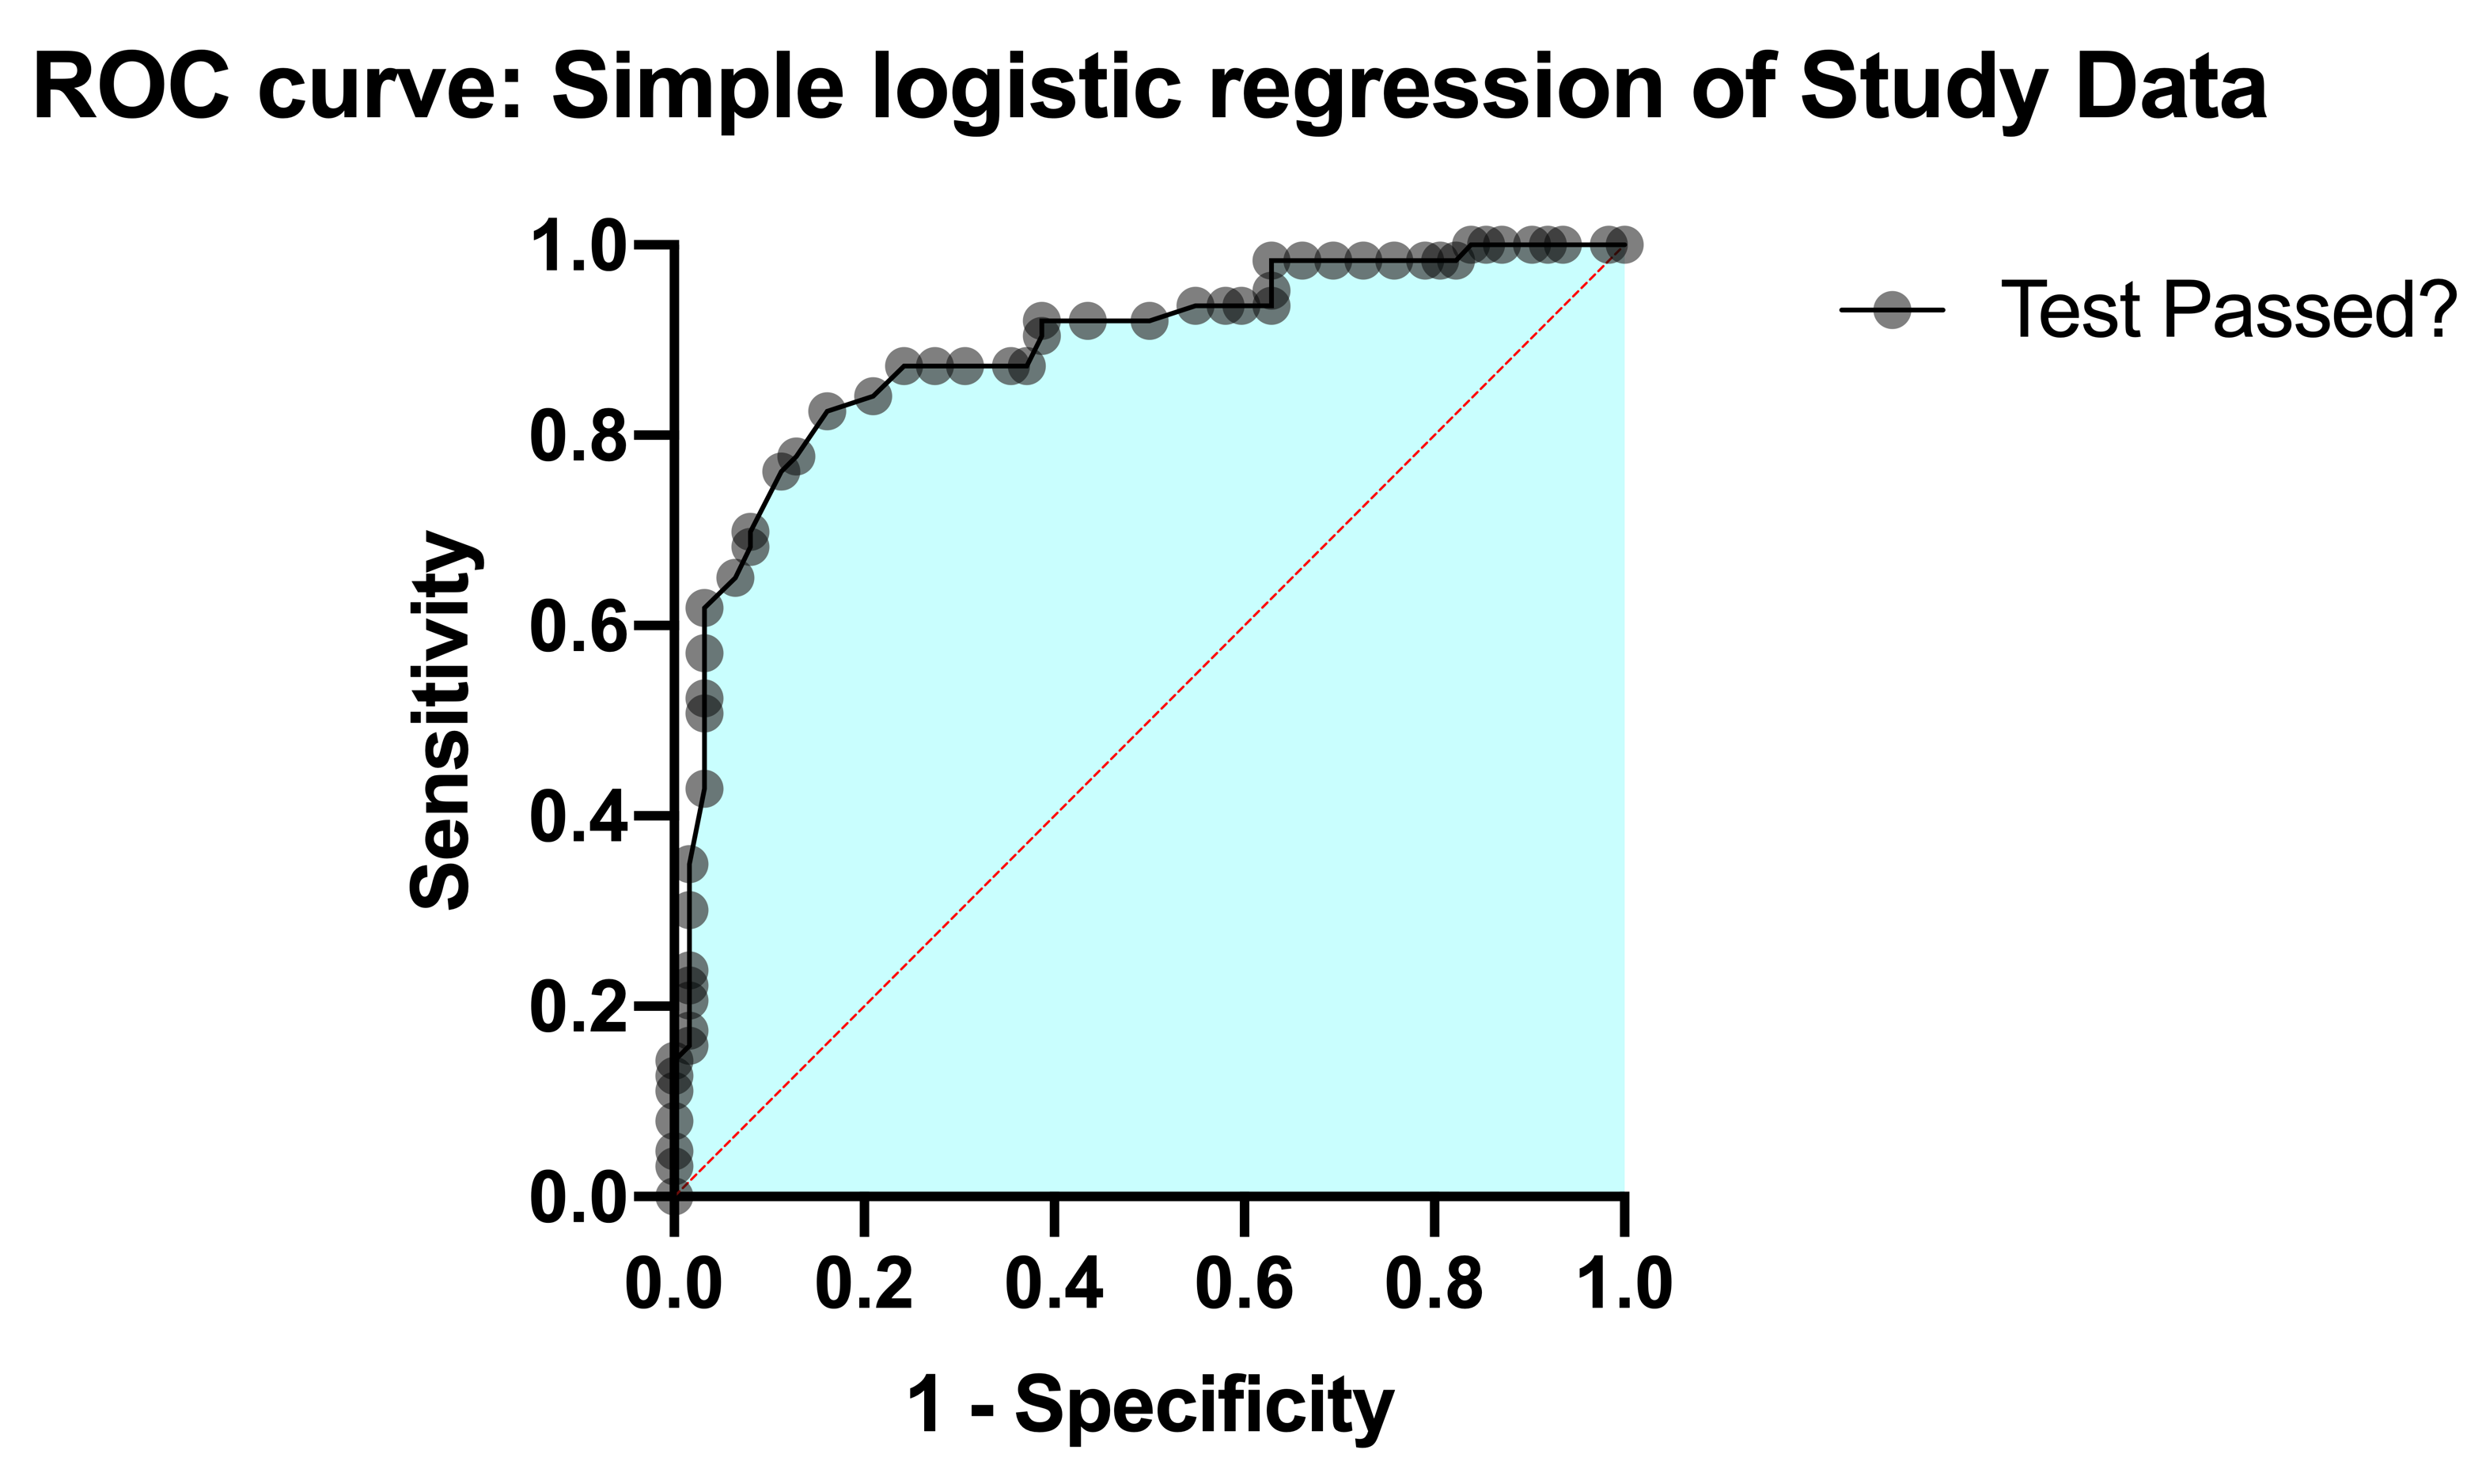
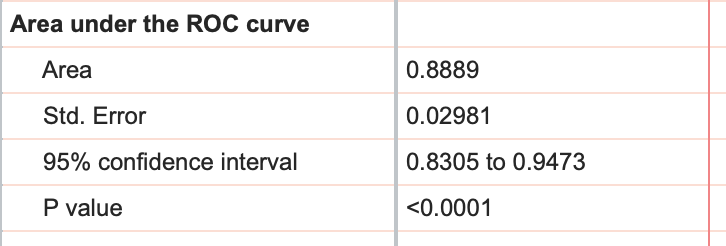
ROC曲线下面积(AUC)是衡量拟合模型正确分类成功/失败情况的指标。该值始终介于0到1之间,下面积越大,表示模型的分类能力越强。 在本例中,ROC曲线(如下图所示)的AUC值为0.8889,该值与AUC的标准误差、95%置信区间以及P值(零假设:AUC为0.5)一同列于结果表中。 如需了解更多关于逻辑回归中 ROC 曲线的信息及相关数学原理,请参阅相关资料。
拟合优度及其他模型细节
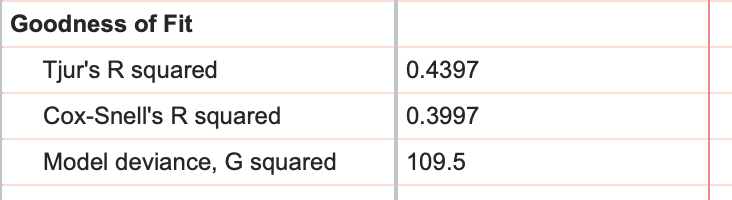
在计算结果的最后一部分,Prism 提供了一些额外指标,旨在概括模型对给定数据的拟合程度。 其中前两项是 Tjur 的 R 平方和 Cox-Snell 的 R 平方,尽管名称中包含“R 平方”,但这些指标的解读方式与线性和非线性回归中的 R 平方截然不同。 相反,这些值被称为伪R平方值,能提供关于模型拟合的不同类型信息。对于这些指标,计算出的值将在0到1之间,数值越高表明模型与数据的拟合效果越好。
在提供的两个伪R平方值中,Tjur的R平方更易于计算和解读:先计算观测到的成功案例的平均预测成功概率,以及观测到的失败案例的平均预测成功概率,然后计算这两个值之间绝对值。这就是Tjur的R平方!
Prism 报告的最后一项指标是模型偏差。该值的计算是简单逻辑回归报告的所有指标中难度最大的之一,因此此处不再赘述。 不过,该指标为“模型(采用结果中先前给出的参数)生成观测数据的可能性有多大”提供了一个数值估计。 听起来可能有些令人困惑,但关键在于:若您正在比较多个用于描述同一数据的模型,模型偏差值越小,则表示模型拟合度越好(模型偏差不能为负值,偏差值为零表示模型与数据的拟合是完美的)。
方程与数据摘要
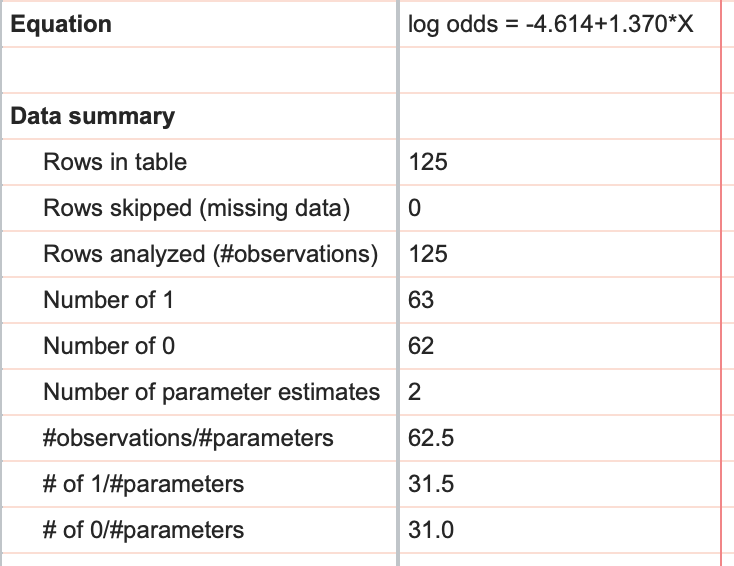
Prism 通过简单逻辑回归提供的最后几项信息包括模型方程(以对数几率形式给出)以及数据摘要,其中包含数据表的行数、被跳过的行数,以及这两者之间的差值——即分析中的观测值数量。 此外,数据摘要中还给出了“1”的总数和“0”的总数。 最后,还提供了三个比率:观测值数与参数数的比、1的个数与参数数的比,以及0的个数与参数数的比(我们建议,对于逻辑回归,后两个比率应至少为10)。