Prism 为多重 t 检验(及非参数检验)分析提供了许多重要选项,允许您针对数据表的每一行从众多不同的检验方法中选择一种进行检验。
“实验设计”选项卡
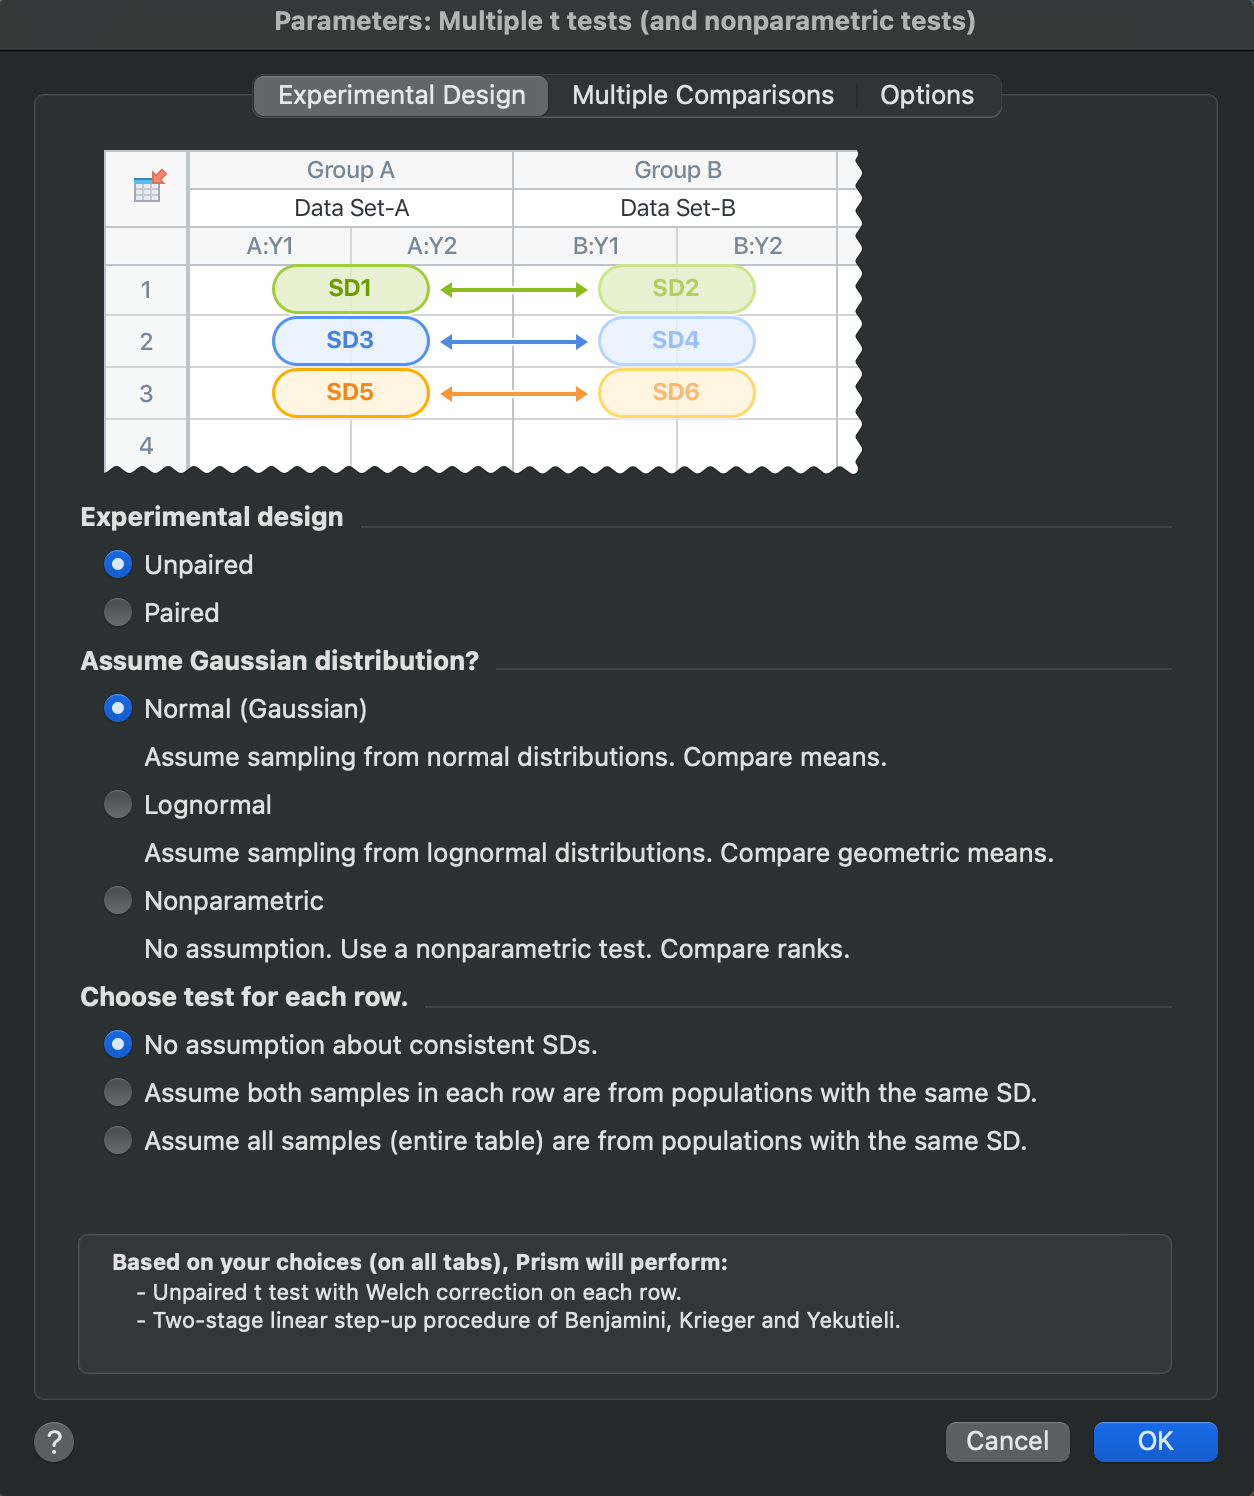
“参数:多重 t 检验(及非参数检验)”分析对话框的第一个选项卡提供了多项选项,您只需回答以下三个问题,即可指定要执行的分析类型:
1.数据是配对的还是非配对的?
2.检验是否假设数据采样自正态(高斯)分布、对数正态分布,还是不对分布作任何假设(非参数)?
3.(对于正态和对数正态分布的假设):检验是否对方差齐性(标准偏差或几何标准偏差)作出任何假设?
4.根据前两个问题的答案,Prism 应执行哪种特异性检验?
实验设计:数据是配对的还是非配对的?
第一个问题涉及所比较的每个主组内数据之间的关系。如果选择了“配对”选项,则意味着每个主列的第一子列中的数据是配对或匹配的,每个主列的第二子列中的数据也是配对或匹配的,以此类推。 可选择此选项的情况包括:
•对同一受试者在不同时间点进行测量(例如,治疗前后)
•对根据年龄、族裔或疾病严重程度等特征招募或匹配的个体进行测量。在此情况下,一名个体可能接受一种治疗,而另一名则接受另一种治疗(或作为对照)
•您多次进行实验室实验,每次均并行处理对照组和实验组样本。如果各样本间的不可控实验条件存在细微差异,这一点可能尤为重要
•您对具有某种固有配对关系的个体(如双胞胎或亲子配对)进行变量测量
请注意,配对应由实验设计决定,绝不能基于所分析的变量。例如,若您正在比较两组受试者的血压测量值,根据年龄或体重进行配对是可行的,但根据其记录的血压值进行配对则不可行。
分布假设
许多统计分析对被分析数据的抽样总体都作出了某些假设。检验中常见的假设之一与数据抽样所依据的总体分布有关。Prism 提供了三种选择:
1.正态(高斯)——假设从正态分布中抽样。比较各组的平均值
2.对数正态——假设数据来自对数正态分布。比较各组的几何均值
3.非参数——不假设数据采自特异性分布,而是使用非参数检验。这通常等同于比较组内数据的秩
非参数检验并不基于数据来自高斯分布(或任何其他特异性分布)的假设。这可能使其看起来更具吸引力。然而,非参数检验的功效较弱。决定何时使用非参数检验并非易事。
为每行选择检验方法
根据前两节中选择的选项,在“分析参数”对话框的“实验设计”选项卡上,最终需要决定的是执行哪种特异性的检验。每行总共可以执行七种检验,其中一些检验还有其他需要考虑的选项。下面将介绍每种检验以及本节中可用的选项。
1.非配对、正态(高斯)分布。在前两节中选择此组合选项后,需就分析中各组的标准偏差做出最终决定。
o第一种选择不对任何行或列数据的抽样总体标准偏差做出任何假设。选择此选项后,Prism 将执行方差不齐的非配对t检验(有时称为带韦尔奇校正的非配对t检验)。 对于从正态分布中抽样的非配对数据,这通常应作为您的默认选择。
o下一个选项是假设——对于每一行——两个组的数据均来自标准偏差相同的总体(换言之,第一列中某一行数据的总体标准偏差与第二列中同一行数据的总体标准偏差相同)。这将针对每一行执行标准的非配对t检验,并为每一行分别估计方差。
o本节的最后一种选择允许假设所有数据(所有行上的所有组)均来自标准偏差相同的总体。请注意,这并不意味着样本标准偏差必须完全相同。 相反,此处的假设是样本中的变异性是随机的,且所有行中的所有数据均来自标准偏差相同的总体。这是方差齐性的假设,会带来更多的自由度,从而提高功效。选择此选项后,Prism 将执行非配对t检验,采用单一合并方差
2.配对,正态(高斯)分布。在前两节中选择此选项组合后,Prism 将仅提供一种检验:
o配对t检验。该检验的零假设是:每对样本间差值的平均值为零
3.非配对,对数正态分布。在前两节中选择此选项组合后,需就分析中各组的标准偏差做出最终决定。
o第一种选择不对任何行或列数据的抽样总体几何标准偏差做出任何假设。选择此选项后,Prism 将针对每一行执行采用韦尔奇校正的对数正态 t 检验。对于从对数正态分布中抽样的非配对数据,这通常应作为您的默认选择。
o下一个选项是假设——对于每一行——两个组的数据均采样自具有相同几何标准偏差的总体 (换言之,第一列某一行数据的母体几何标准差与第二列同一行数据的母体几何标准差相同)。 请注意,该假设等同于假设对数转换后总体方差相等。这将对每一行执行标准的对数正态 t 检验。
o本节中的最后一个选项允许假设所有数据(所有行上的所有组)均采样自标准偏差相同的总体。 请注意,这并不意味着样本的几何标准偏差必须完全相同。相反,此处的假设是样本中的变异性是随机的,且所有行中的所有数据均来自具有相同形状参数(几何标准偏差)的总体。 这就是方差齐性假设,它会增加自由度,从而提高功效。选择此选项后,Prism 将进行非配对t检验,并采用单一合并方差
4.配对,对数正态分布。在前两节中选择此选项组合后,Prism 仅提供一种检验:
o比率t检验。该检验的零假设稍显复杂。简而言之,其零假设为:每对样本比值的对数均值为零(换言之,由于 log(1) = 0,因此每对样本的比值均为 1)
5.非配对、非参数检验。选择此选项组合后,需在以下两种检验中选择其一:
oMann-Whitney检验. 该检验的零假设可能难以理解,相关内容将在下文讨论。但需要注意的是,该检验的原理是将待比较的两组所有数据按从小到大的顺序排列(无论该值属于哪一组)。 随后,为每个值分配一个序数,从最小值的1开始,到最大值的n结束(其中n为值的总数)。该检验随后比较被比较的两组数据的平均序数。
oKolmogorov-Smirnov检验。该检验的零假设虽然难以理解,但其假设是:被比较的两组数据均采自具有相同分布的总体。该检验利用数据的累积分布来检验是否违反了这一零假设(即中位数不同、方差不同或分布不同)。 有关Kolmogorov-Smirnov检验的更多信息
6.配对非参数检验。选择此选项组合仅会产生一种可能的检验:
oWilcoxon配对检验。该非参数检验首先计算待分析两组中各成对值之间的差值,对这些差值的绝对值进行排序,然后比较第一组成对值较高的秩和与第二组成对值较高的秩和。 该检验的原理较为复杂,本指南中的其他页面提供了更多关于如何解释该检验结果的信息。
“多重比较”选项卡
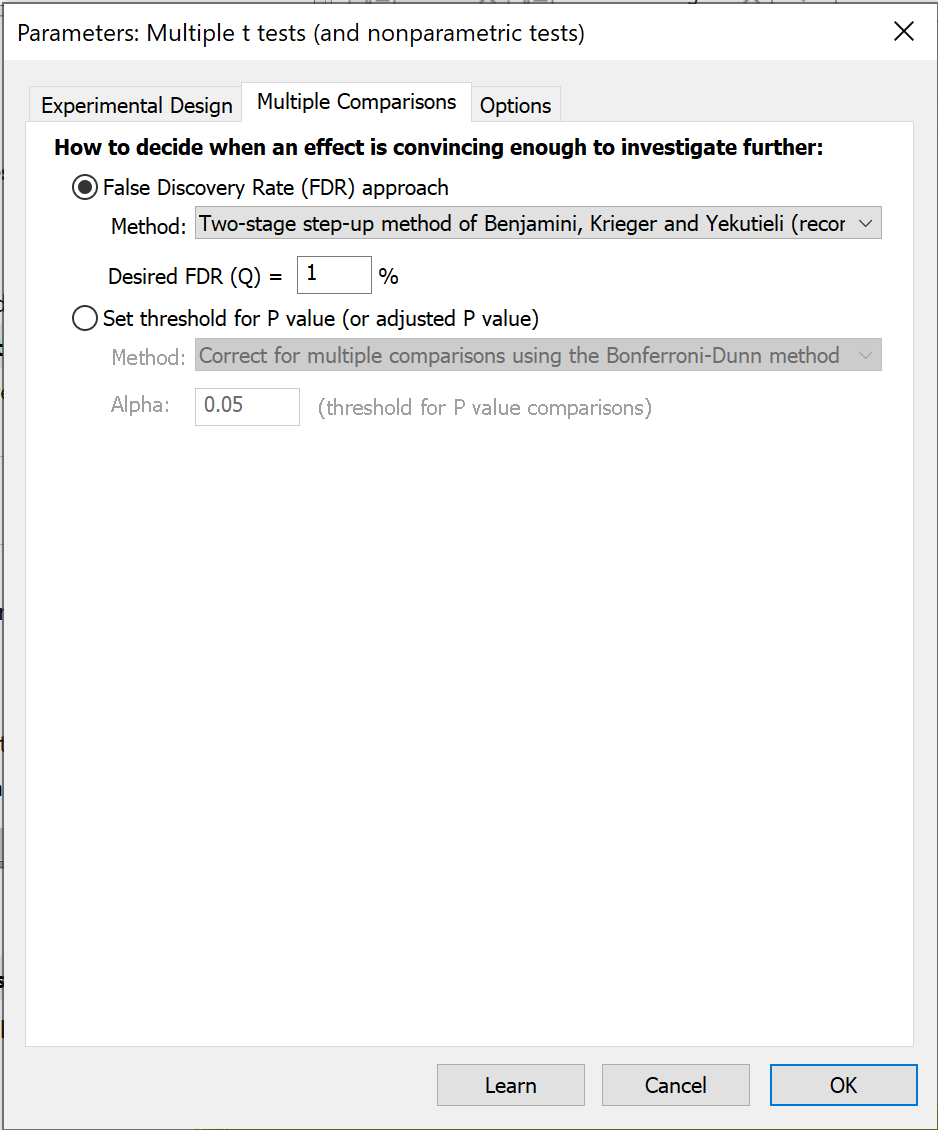
当一次性执行大量 t 检验时,通常的目标是筛选出那些差异似乎足够显著、值得进一步调查的比较子集。Prism 提供了两种方法,用于在完成多重 t 检验(及非参数)分析后,判断双尾 P 值何时足够小,从而使该比较值得进一步研究。
一种方法基于大家熟悉的统计学显著概念。
另一种方法是基于错误发现率(FDR;推荐)进行决策。控制 FDR 的核心理念与将某些比较判定为“统计学显著”截然不同。该方法不使用“显著”一词,而是使用“发现”一词。 您需要设定 Q,即“发现”中作为虚假发现的期望最大百分比。换言之,这就是期望的最大 FDR。
在所有被标记为“发现”的数据行中,目标是其中因数据随机散布而产生的虚假发现比例不超过 Q%,同时至少有 100% - Q% 的“发现”是总体均值之间的真实差异。了解更多关于 FDR 的信息。Prism 提供了三种控制 FDR 的方法。
如何处理多重比较
如果您选择了“错误发现率(FDR)”方法,则需要为 Q 设定一个数值,即可接受的最终被证实为假发现的结果所占的百分比。 请输入百分比,而非分数。如果您愿意接受 5% 的发现结果为假阳性,请输入 5,而非 0.05。您还需要选择要使用的方法。
如果您选择使用统计学显著方法,则需要就多重比较问题做出额外决定。您有四种选择:
•使用 Holm-Šídák 方法对多重比较进行校正(推荐)。 您需指定用于整个 P 值比较族所采用的阈值水平 α。该方法的设计原理是:当所有行中的比较所对应的零假设均成立时,所指定的 α 值代表在一次或多次比较中获得“显著” P 值的概率。
•使用 Šídák-Bonferroni 方法对多重比较进行校正(不推荐)。我们建议使用 Holm-Šídák 方法(见上文),因其具有更高的功效。 Šídák-Bonferroni 法(通常简称为 Šídák 法)的功效略高于普通的 Bonferroni-Dunn 法(通常简称为 Bonferroni 法)。当进行大量比较时,这一点尤为明显。
•使用 Bonferroni-Dunn 方法对多重比较进行校正(不推荐)。Bonferroni-Dunn 方法比 Holm-Šídák 方法更易于理解且更为人熟知,但除此之外并无其他优势。 Bonferroni-Dunn方法与Šídák-Bonferroni方法的主要区别在于:Šídák-Bonferroni方法假设每次比较彼此独立,而Bonferroni-Dunn方法则不作此独立性假设。 因此,希达克-邦费罗尼法的功效略高于邦费罗尼-邓恩法
•不进行多重比较校正(不推荐)。每个 P 值均单独解读,不考虑其他比较结果。您需设定显著性水平 α 的值,通常设为 0.05。该值作为阈值,用于与 P 值进行比较。 如果 P 值小于 α,则该比较被视为“统计学显著”。如果采用这种方法,请注意您会得到大量假阳性结果(即许多看似“显著”但实际上并不成立的发现)。 在某些情况下这并无大碍,例如药物筛选,其中多次 t 检验的结果仅用于设计下一阶段的实验。
“选项”选项卡
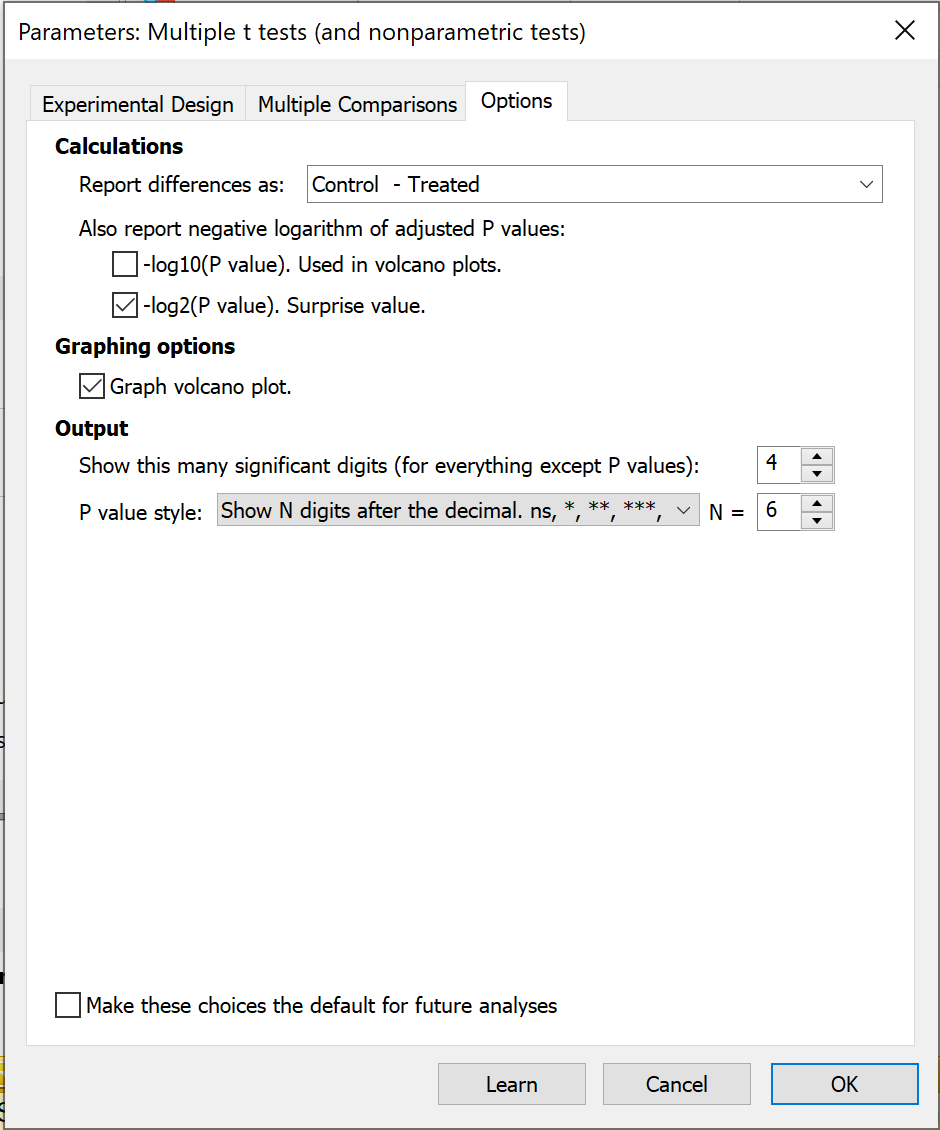
“参数:多重 t 检验(及非参数检验)”分析对话框中的第三个也是最后一个选项卡提供了许多重要的控制选项,用于设置分析结果的报告方式以及 Prism 将根据该分析生成何种可视化图表。
计算
在此部分,您可以选择分析中两个组之间的比较顺序。例如,您可能希望将差异报告为“处理组 - 对照组”,而不是“对照组 - 处理组”。 请注意,这不会改变检验的总体结果,仅会改变差异的“符号”。
此外,本节还提供了一个选项,可对计算出的 P 值进行两种基于对数的变换:
•-log10(P值) — 此变换用于生成结果的火山图,该选项可用于生成这些结果的表格(便于与图表形式的火山图一同呈现)
•-log2(P值) —— 这是计算得出的P值的2进制对数,有时也被称为“香农信息值”、“意外值”或“S值”。对计算出的P值进行这种简单的转换,为理解P值提供了一种直观的方式。 应用此变换后得到的值 S 可按以下方式解读:我们对所获得的 P 值的惊讶程度,不应超过抛硬币 S 次且每次都出现正面时所感到的惊讶程度。 举个例子,假设我们得到的 P 值为 0.125。相应的 S 值为 3,我们对获得 0.125 这个 P 值的惊讶程度,不应超过抛硬币三次且每次都出现正面时的惊讶程度(这并不太令人惊讶)。 现在假设我们得到的P值为0.002。相应的S值约为9,我们对得到0.002这个P值的惊讶程度,应该不会超过抛硬币九次且每次都出现正面时所感到的惊讶(这要令人惊讶得多!)。
绘图选项
此处的复选框(默认启用)会使 Prism 为您的数据生成一个火山图。X 轴表示每行均值之间的差异。Y 轴绘制的是 P 值的变换值。 具体来说,它绘制的是 P 值的负对数。因此,如果 P=0.01,则 log(P)=-2,而 -log(P)=2,图中绘制的就是该值。因此,差异较大的行位于图表两端,而 P 值较小的行则位于图表较高处。
Prism 会自动在 X=0(无差异)处绘制一条垂直网格线,并在 Y=-log(alpha) 处绘制一条水平网格线。位于该水平网格线上方的数据点,其 P 值小于您选择的 alpha 值。
输出
最后,在此选项卡中,提供了相关控件,允许您控制分析结果中显示的有效数字位数(P值除外),以及报告P值时采用的格式样式。
