《异常值》
请谨慎使用
自动异常值剔除功能非常有用,但在某些情况下可能会导致结果无效(甚至产生误导),因此应谨慎使用。您可以要求 Prism 仅识别并统计其判定为异常值的数值;或者要求它将已识别的异常值从拟合的数据集中剔除。
ROUT系数
若选择排除或标记异常值,请设置 ROUT 系数 Q 来确定 Prism 判定异常值的严格程度。
我们建议将该值设为 1%。我们的模拟结果表明,如果所有数据点都服从高斯分布,Prism 将在约 2-3% 的实验中错误地检测到一个或多个异常值。如果数据中确实存在异常值,Prism 检测它们时的错误发现率将低于 1%。参见参考文献 1。
若将 Q 设为较高值,定义异常值的阈值将不那么严格。这意味着 Prism 的异常值检验力会增强,但同时也会更频繁地错误地将某些数据点判定为“异常值”。 若将 Q 设为较低值,定义异常值的阈值将更严格。这意味着 Prism 的异常值检验力会降低,但将某一点错误地定义为异常值的可能性也会减小。
若将 Q 设为 0,Prism 将使用普通非线性回归拟合数据,而不进行异常值识别。
创建清理后数据的表格
选中该选项(Prism 8 版本新增),将创建一个包含已清理数据(不含异常值的数据)的分析标签页。Prism 不会自动对该已清理数据表绘制图表,但操作起来非常简单(“新建”...“现有数据图表”)。
Prism 始终会在分析选项卡中生成包含异常值的表格,且无法通过选项隐藏该表格。
拟合方法
Prism 提供四种拟合方法供选择:
最小二乘法
这是标准的非线性回归。Prism 会使数据点与曲线之间的垂直距离平方和最小化,简称最小二乘回归。如果您假设残差(数据点到曲线的距离)服从高斯分布,则此方法是合适的选择。
稳健回归
稳健回归受异常值的影响较小,但无法生成参数的置信区间,因此实用性有限。它在 Prism 中的主要用途是作为异常值检测的第一步。它是判断残差是否“过大”从而将该点判定为异常值的基准。 单独进行鲁棒回归通常帮助不大,但若您有此需求,Prism 仍为您提供了这一选项。
Poisson回归
当每个 Y 值均为您计数的对象或事件数量时,请选择Poisson回归。这些必须是实际计数值,不得进行任何标准化处理。例如,如果仪器显示您的样本每分钟有 98.5 次放射性衰变,但您要求计数器对每个样本计数 10 分钟,那么计数器将记录 985 次放射性衰变。 这就是您在Poisson回归中应输入的数值。如果 Y 值为归一化计数(而非实际计数),则不应选择Poisson回归。
不要拟合
非线性回归采用迭代方式,并以各参数的初始值开始。勾选“不拟合曲线”以查看由初始值生成的曲线。如果曲线与数据点相距甚远,请返回“初始参数”选项卡,并输入更合适的初始值。重复此过程,直到曲线接近数据点。 然后返回“方法”选项卡,勾选“拟合曲线”。这通常是诊断非线性回归问题的最佳方法。
收敛准则
非线性回归是一个迭代过程。它从参数的初始值开始,然后反复调整这些值以提高拟合优度。当调整参数值对拟合优度的影响微乎其微时,回归过程即告结束。
标准应设多严格?
Prism 允许您通过三种方式定义收敛准则。
•快速。如果您正在拟合庞大的数据集,可以使用“快速”收敛定义来加快拟合速度。选择此选项后,当连续两次迭代中平方和的变化幅度小于 0.01% 时,即判定非线性回归已收敛。
•中等(默认)。当连续五次迭代中,平方和的变化幅度小于 0.0001% 时,非线性回归即被视为收敛。
•严格。若难以获得合理的拟合结果,不妨尝试更严格的收敛定义。选择此选项时,非线性回归迭代将持续进行,直到连续五次迭代中,平方和的变化幅度小于 0.00000001%。 虽然这通常帮助不大,但或许值得一试。不总是使用最严格选项的唯一原因是,计算完成所需的时间会更长。对于小数据集而言这并不重要,但在处理大数据集或运行脚本分析多个数据表时,这一点就显得尤为重要。
最大迭代次数
在拟合曲线时,Prism 将在达到该迭代次数后停止。默认值为 1000,通常没有必要输入其他数值。 一个例外情况是,当您运行脚本自动分析多个数据表时,每个数据表都包含大量数据点。此时拟合速度可能较慢,因此降低最大迭代次数是合理的,这样 Prism 就不会在尝试拟合无法拟合的数据上浪费时间。
加权方法
对数据点进行差异化加权通常很有用。了解原因。
Prism 在非线性回归的“方法”选项卡中提供了七种选择:
不加权。回归通常通过最小化数据点到直线或曲线的垂直距离的平方和来实现。 距离曲线越远的数据点,对平方和的贡献越大;距离曲线越近的数据点,贡献则越小。当您预期曲线各部分的实验散布在平均意义上保持一致时,这种做法是合理的。
按 1/Y² 加权。在许多实验情境中,当 Y 值较高时,数据点到曲线的平均距离(或更准确地说,距离的平均绝对值)通常会更大。散布较大的数据点将产生更大的平方和,从而在计算中占据主导地位。 若预期相对距离(残差除以曲线高度)保持一致,则应采用 1/Y² 作为权重。
按 1/Y 加权。当离散度服从泊松分布时,此选项非常有用——即当 Y 代表定义空间内的对象数量或定义区间内的事件数量时。
按 1/YK 加权。也称为“通用加权”。阅读更多。
按 1/X 或 1/X² 加权。这些选项很少使用。仅当这是您所在领域的标准做法时才选择这些加权方案,例如生物测定中的线性拟合。
按 1/SD² 加权。如果您在每个 X 值处输入重复的 Y 值(例如三重复),可能会倾向于根据重复测定的离散程度对数据点进行加权——当三重复数据点间距较大、标准偏差 (SD) 较高时,该数据点的权重会相应降低。 但除非您有大量重复测量,否则这种做法帮助不大。构成一个均值的三组重复测量可能因偶然因素而分布较远,但该均值可能与其他均值同样准确。 加权必须基于离散度的系统性变化。当您希望使用 Prism 中未提供的加权方案时,采用 1/SD² 作为加权系数最为有效。在这种情况下,请将数据作为均值和标准差输入,但将您在其他地方为该数据点计算出的加权值作为“SD”输入。 换言之,您在“SD”子列中输入的值实际上并非标准偏差,而是另行计算的加权因子。
关于加权的说明
•如果您已对数据进行了归一化处理,则加权通常没有意义。
•模拟可以向您展示,如果选择了错误的加权方案,会产生多大的差异。
•如果您选择不均匀加权,Prism 在绘制残差图时会将此因素考虑在内。
•Prism 在计算 R² 时会考虑加权因素。
•如果您在“拟合方法”部分选择了稳健拟合,则“加权方法”部分中的某些选项将不可用。请注意,您选择的加权方式将影响 Prism 计算和绘制的残差,以及它识别异常值的方式。 异常值检测和处理的选项也可在“方法”选项卡中找到,而绘制残差图的选项则位于非线性回归的“诊断”选项卡中。
•如果您要求 Prism 去除异常值,加权选项不会影响第一步(稳健回归)。随后,系统会通过观察加权残差的大小来识别异常值。最后,对经过清理(不含异常值)的数据进行加权回归拟合。
重复测量
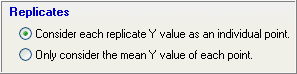
选择是拟合所有数据(如果您输入了重复测量数据,则为单个重复测量;如果您以这种方式输入数据,则需考虑标准差或标准误差以及样本量),还是仅拟合均值。
若仅对均值进行拟合,Prism“观察”到的数据点较少,因此参数的置信区间往往较宽,且比较替代模型的检验力较弱。基于这些原因,在可能的情况下,应选择让回归模型将每个重复样本视为一个数据点,而非仅考虑均值。
这个问题归根结底涉及独立性。回归分析的一个重要假设是:所有数据点的残差相互独立。本示例中,重复测量不独立,此时应仅拟合均值:您进行了一项剂量-反应实验,每个剂量使用不同的动物,并进行了三次重复测量。 这三组测量值并不独立,因为如果某只动物的反应恰好比其他动物更强烈,那么所有重复测量的结果很可能都较高。由于重复测量之间不独立,您应拟合均值,而非单个重复测量值。
如果您将数据输入为均值、样本量(n)和标准差(SD)或标准误(SEM),Prism 会提供两种选择:仅拟合均值,或同时考虑标准差和样本量。如果您选择后者,Prism 通过最小二乘回归计算出的结果将与您输入原始数据时完全一致。
参考文献
1.Motulsky HM 和 Brown RE,《使用非线性回归拟合数据时检测异常值——一种基于稳健非线性回归和错误发现率的全新方法》,《BMC生物信息学》2006,7:123。
